Macの音を全部字幕にする自作アプリから、Ollama前提を外した
英語の動画を見ていて、字幕が無いと置いていかれる。YouTube なら自動翻訳の字幕があるが、あれが付くのは YouTube の中だけだ。配信、会議アプリ、手元の動画ファイル、X に流れてくる動画。Mac で鳴る英語の大半には、字幕が付かない。
それが嫌で、Mac で鳴っている音を全部その場で日本語の字幕にするアプリを自分で作った。名前は Live Subtitle。聞き取りも翻訳も Mac の中だけで動く。音声を外のサービスに送らない。ソースは GitHub の mlabo-org/live-subtitle で公開している。
この記事では、まずこのアプリが何をするものかを実際の画面で見せる。そのあとで、今回やった改良の話をする。ローカルの翻訳を Ollama に頼っていたのをやめて、アプリだけで翻訳まで動くようにした。作業は Claude Code に頼んだ。俺がやったのは、横から思いつきを言うことと、Mac が熱いと文句を言うことだ。AI に開発を頼むときのコツは、バイブコーディングの始め方にまとめてある。
字幕の道具を探している人は前半だけ読めば足りる。自分のアプリにローカルの LLM を組み込みたい人は、後半に実測の数字と落とし穴を置いてある。

contents
Mac で鳴っている音が、そのまま日本語字幕になる
Live Subtitle は、Mac で鳴っているすべての音声を聞き取り、選んだ言語の字幕にする macOS 用のアプリだ。YouTube でも、X でも、会議アプリでもいい。どのアプリが鳴らしているかは関係ない。Rust で書いてあり、画面は egui という部品で作っている。
英語の動画を流すだけで、原文と訳が並ぶ
説明より画面のほうが早い。英語の動画を流しながら撮ったのがこれだ。
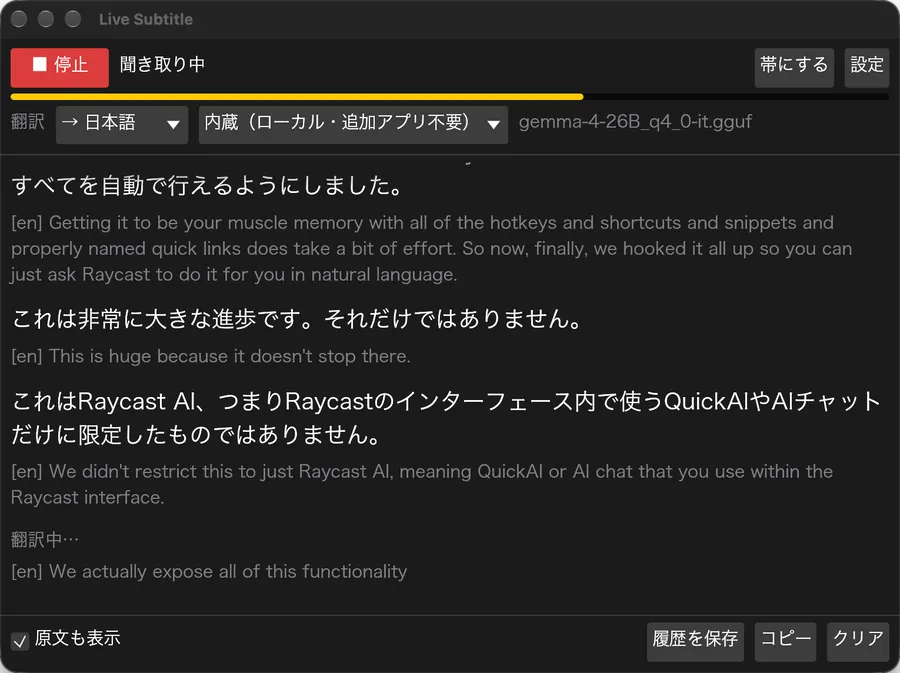
流していたのは Raycast というアプリの紹介動画だ。白い大きな字が日本語訳で、その下の灰色の小さい字が、聞き取った英語の原文になる。「これは非常に大きな進歩です。それだけではありません。」の下に「This is huge because it doesn’t stop there.」とある。原文と訳が上下に並ぶので、訳が怪しいと思ったらすぐ原文を確かめられる。
操作は「開始」を押すだけだ。上の段に「停止」「帯にする」「設定」のボタンと、訳す言語、翻訳先の選択がある。画面の下には「原文も表示」「履歴を保存」「コピー」「クリア」が並ぶ。覚えることはこれで全部になる。
音が字幕になるまでの道のり
中で起きていることを、音の通り道の順に書く。
- 音を取る: macOS の ScreenCaptureKit という仕組みで、Mac が出している音を受け取る。
- 音量をそろえる: 取れた音は小さいので、自動で持ち上げる。
- 声の区間を見つける: Silero VAD という音声検出のモデルが、声が鳴っている区間を判定する。風や人混みのような音は、声として扱わない。
- 聞き取る: whisper.cpp が、声を文字にする。モデルは large-v3-turbo で、大きさは約 574 MB。話されている言語は 1 行ごとに自動で判定する。
- 訳す: 聞き取った文を、翻訳先に渡す。
- 字幕に出す: 原文と訳を画面に出す。
5 番の「翻訳先」が、この記事の後半の主役になる。選べるのは 4 つで、アプリに入っている内蔵エンジン、Ollama、Claude、Codex だ。
原文は先に、訳はあとから
さっきの画面の一番下を見てほしい。最後の行は、訳のところが「翻訳中…」になっていて、原文だけが先に出ている。
これは仕様だ。原文は聞き取れた時点ですぐ出し、訳は出来上がり次第あとから差し込む。翻訳が遅い瞬間があっても、字幕そのものは止まらない。英語が少し読める人なら、原文を追いながら訳を待てる。
もう一つ、地味だが効いている工夫がある。翻訳は文ごとに行う。人の話は、息継ぎや間で、文の途中でも切れる。切れた断片をそのまま訳すと、「そして、そこには…」のような、途中で終わる訳が量産される。以前はまさにそうなっていた。今は、文の途中で切れた残りは原文だけ先に出して待ち、次の発話とつないで、文が終わってから訳す。
 じぴこ
マスター、以前は「そして、そこには…」で終わる字幕を、ずっと眺めていたんですね。
 管理人
続きが気になる字幕ではあった。続きは来なかったけどな。
動画の上に置ける「帯」と、実用で効く作り
字幕は、読む場所が動画から離れていると疲れる。視線が動画とウィンドウを往復するからだ。そこで、字幕だけを細い帯にして、動画に重ねられるようにしてある。
帯にすると、テロップになる
「帯にする」を押すと、ウィンドウがこうなる。
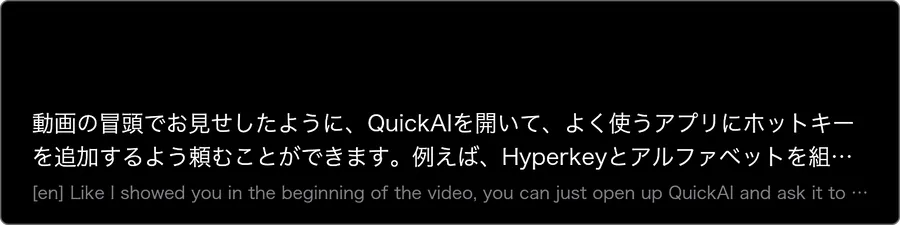
タイトルバーもボタンも消えて、字幕だけが残る。テレビのテロップと同じだ。帯はドラッグで好きな位置に動かせて、縁をドラッグすれば大きさも変えられる。全画面表示の動画の上にも重なる。話が途切れている間も、帯は消えずに残る。
YouTube の自動翻訳字幕との違いは 2 つある。字幕が付く対象が、ひとつのサイトの動画から、Mac で鳴るすべての音に広がること。そして、字幕を置く場所を自分で決められることだ。字幕の無い動画にも、配信にも、会議アプリの音にも付く。
帯を高くすると、最新の字幕の上に、それより前の字幕が薄く積み重なる。聞き逃した一つ前の文を、目を上げるだけで拾える。元の画面に戻すときは Esc を押す。
限界も書いておく。聞き取るのは Mac が出している音だけで、マイクの音は拾わない。目の前の人の声を字幕にする道具ではない。それと、音楽を声と取り違えることがある。歌の無い曲でも起きる。
13 の言語と、あとで読み返せる履歴
訳す先は日本語だけではない。日本語、英語、中国語(簡体字)、韓国語、タイ語、ベトナム語、インドネシア語、スペイン語、フランス語、ドイツ語、イタリア語、ポルトガル語、ロシア語の 13 から選べる。
話されている言語のほうは、1 行ごとに自動で判定する。whisper が聞き取れる言語なら、何語の音声でもいい。日本語の動画にタイ語の字幕を付ける、という使い方もできる。選んだ言語で話された音声は、訳さずにそのまま出す。
「履歴を保存」を押すと、そのときの字幕を、原文・訳・時刻つきのテキストファイルに保存する。動画や会議の中身を、あとで文字で読み返せる。押さない限り、何も保存しない。
マイクも映像も API キーも使わない
常に動かしておく道具は、余計なものに触らないことが大事だ。このアプリが触らないものを並べる。
- マイク: 使わない。取るのは Mac が出している音だけ。
- 画面の映像: 使わない。macOS の許可の名前は「画面収録とシステムオーディオ録音」だが、取得するのは音声だけだ。
- API キー: 使わない。Claude と Codex を翻訳先にするときは、Mac に入っている公式のコマンドを、そのログインのまま使う。
- Mac の音量: 触らない。音量の補正は、取り込んだ音の複製にだけ掛ける。スピーカーから出る音は変わらない。
内蔵エンジンか Ollama を翻訳先にすれば、聞き取りから翻訳まで、全部が Mac の中で終わる。ネットワークが無くても動く。
「Ollama前提ってちょっと違う気がする」から内蔵エンジンへ
ここからが今回の改良の話だ。きっかけは、俺が Claude Code に投げた、何気ない確認だった。
ローカル翻訳は、Ollama への注文票だった
このアプリのローカル翻訳は、Ollama で動かしていた。Ollama は、手元の Mac で LLM を動かすための定番のアプリだ。ただ、自分のアプリの中がどうなっていたかは、うろ覚えだった。
管理人ローカルの翻訳ってさ、Ollamaサーバーから、ローカルのLLMを読んでるよな
Claude Code はソースを調べて、こう返してきた。
 クロード君
アプリが LLM を自分の中に読み込んでいるわけじゃない。推論は Ollama のプロセスが担当していて、こっちは注文票を渡して返事を待つだけ。
注文票。うまいことを言う。アプリは http://127.0.0.1:11434 に翻訳の依頼を送り、返事を待っているだけだった。モデルは gemma4:26b-mlx を使っていた。厨房は隣の店にあって、うちは注文を取り次いでいただけ、ということになる。
自分で使う分には、これで何も困らない。困るのは、このアプリを公開するときだ。
管理人このrepoは未公開なんだけどさ、公開するとなると、Ollama前提ってちょっと違う気がするんだよな。
字幕が欲しくてこのアプリを入れた人に、「まず Ollama を入れて、起動して、18 GB のモデルを取得してください」と言うことになる。出前を頼もうとしたら、先に別の出前アプリを入れてくれと言われる店だ。俺ならその時点で帰る。
モデルのデータについても、言いたいことがあった。
管理人あるならデーターはそれを借用して、無いならダウンロードして、自前でデーターを用意するみたいな方が、公開物としては良い様な気がしているんだけど。
十数 GB のファイルを、すでに持っている人に二重に落とさせたくない。持っていない人には、アプリが自分で取りに行く。この方針が、あとで出てくるモデル探しの土台になる。
Ollama の中をのぞいたら、同じことをしていた
Ollama を外すなら、推論する部分を自分で持つことになる。最初に考えたのは、Ollama が使っている MLX という Apple の仕組みを、自前で直接使う案だった。
そこで、Ollama が MLX をどう扱っているのかを Claude Code に調べさせた。手元の Ollama 0.35.0 の中身を見た結果が、なかなか面白い。
- MLX の本体と、それを C 言語から呼ぶための層(mlx-c)が同梱されている。
- それを呼んでいるのは、Ollama が Go で書いた専用のプログラムだ。モデルの構造そのものを、Ollama が自分で組み立てている。
gemma4:26b-mlxは、1,072 個の部品に分かれて保存されている。合計 18.3 GB。
つまり MLX で動かす道は、データを借りれば済む話ではなかった。足りないのは、モデルを動かすコードのほうだ。それを自分で書いて保守するのは、字幕アプリの本筋より大きな仕事になる。
そこで俺が言ったのが、これだ。
管理人むしろOllamaのサーバー環境でやる方がプログラム的に楽なら、Ollamaサーバー的なものを自前で用意するのが良いのかな。
推論を自分で書くのではなく、サーバーごとアプリの中に入れてしまう。llama.cpp という定番の推論エンジンには、llama-server という出来合いのサーバーが付いている。それを同梱すればいい。
クロード君実は Ollama 自身がこの作りだった。
Ollama の中に llama-server がそのまま入っていて、本体には「llama-server の起動を待って時間切れ」というエラー文まであった。GGUF という形式のモデルについては、Ollama も裏で llama-server を立ち上げて、注文票を渡しているだけだった。隣の店の厨房も、中をのぞいたら同じ業者が入っていたわけだ。
じぴこマスターの思いつき、Ollama が先にやっていたんですね。
管理人先人と同じ結論に、自力で遅れてたどり着いた。これを再発明と呼ぶ。
llama-server を同梱する。踏んだ落とし穴つき
できあがった内蔵エンジンの作りは、こうなっている。
- 同梱: ビルドのとき、llama.cpp を版を固定して(b12503)ソースからビルドし、できた
llama-serverをアプリの中に入れて署名する。 - 起動: アプリが
llama-serverを子プロセスとして起動する。待ち受けるのは127.0.0.1の空いているポートだけで、外からは届かない。 - 翻訳: 字幕 1 行を、
/v1/chat/completionsに送る。同時に訳すのは 1 行だけ。 - 停止: 「停止」を押すか、アプリを終了すると、サーバーごと止める。モデルが使っていたメモリも、そこで空く。
アプリの側は、もともと「依頼を投げて返事を待つ」作りだった。送り先を Ollama から自分の子プロセスに替えるだけなので、外側の作りはほとんど変わっていない。
同じことをやりたい人のために、ビルドで踏んだ落とし穴を 2 つ書いておく。
1 つ目。llama.cpp のビルドが、ブラウザ用の画面の部品をダウンロードしに行って、失敗した。サーバーをブラウザから触るための画面で、うちには要らない。LLAMA_BUILD_UI=OFF だけでは止まらず、LLAMA_USE_PREBUILT_UI=OFF も必要だった。
2 つ目。ビルドは通ったのに、できた llama-server が Homebrew の OpenSSL に依存していた。このままだと、Homebrew を入れていない Mac では起動しない。LLAMA_OPENSSL=OFF にして、システムに最初から入っているライブラリだけで動くようにした。うちのサーバーは 127.0.0.1 で待つだけで、自分から何かを取りに行くことはない。暗号化の部品は要らなかった。
MLXのほうが速い、を40文で確かめた
設計は決まった。ただ、俺には一つ引っかかっていることがあった。Mac では MLX のほうが速い、という評判だ。内蔵エンジンにして遅くなるなら、Ollama を外した意味が薄れる。
14 GB を落とすところから
管理人一般的に、MacOSでは、mlxがより速いんだろ?
Claude Code は世間の計測を調べてきた。訳文を作る速さは MLX が上、という報告が多い。一方で、Gemma というモデルではほとんど差が無かった、という報告もある。要するに、評判では決まらない。
カタログの最高速度で車を選んでも、自分の通勤路でどちらが速いかは分からない。測るしかない。測るには、llama.cpp で動く形式(GGUF)のモデルが要る。14 GB ある。
管理人ダウンロードして。俺の環境は10G LANだから速いので笑
クロード君ダウンロードを始めた。10G LAN の本領発揮を待つ間、こっちは見てるだけの係。
5 分半ほどで終わった。10G LAN は伊達ではなかった。
使うモデルは、Google の Gemma 4 26B の QAT 版に落ち着いた。QAT 版というのは、小さく圧縮する前提で学習し直したモデルのことだ。ファイルは gemma-4-26B_q4_0-it.gguf、約 14.4 GB。ライセンスは Apache 2.0 で、取得にサインインは要らない。読み込みは約 7 秒で、読み込んでいる間は実メモリに約 14 GB 載る。
速さは、内蔵がわずかに上
比べ方はこうだ。話し言葉風の英語を 40 文用意する。言いよどみや、否定、数字、固有名詞を混ぜてある。それを、アプリが実際に送るのと同じ指示文で、前の 3 行を文脈として付けて、内蔵エンジンと Ollama に交互に訳させる。
| 翻訳先 | 1 文あたりの中央値 | 幅 |
|---|---|---|
| 内蔵(llama-server と GGUF) | 0.75 秒 | 0.48〜0.90 秒 |
Ollama(gemma4:26b-mlx) | 0.88 秒 | 0.54〜1.26 秒 |
40 文のうち 35 文で、内蔵のほうが速かった。差の中央値は 0.15 秒。評判と逆の結果になった。
理由も分かっている。訳文を作る速さだけを見ると、内蔵が 1 秒あたり約 75 トークン、Ollama の MLX 版が約 46〜53 だった。字幕の翻訳は、短い文を 1 つ訳して終わる仕事だ。この使い方では、MLX の強みが出なかった。
正直に言えば、0.15 秒の差は体感できない。大事なのは「速くなった」ことではなく、「内蔵にしても遅くならない」ことのほうだ。Ollama を外せない理由が、これで一つ消えた。
訳の質は、伏せて読み比べた
速くても、訳が悪ければ意味がない。質のほうは、どちらの訳か分からないように並べ替えた一覧を Claude Code に作らせて、1 文ずつ読み比べさせた。採点が終わってから、答え合わせをする。
結果は、はっきりした差が見つからなかった。
- Ollama の MLX 版と、普通に圧縮した 4 ビット版(Q4_0)を伏せて比べた。片方だけ劣る文は、MLX 版が 4、Q4_0 版が 6。
- はっきりした誤訳は、Q4_0 版の 1 文だけだった。「これにうんざりしているのは自分だけじゃないはずだ」を、「自分だけがこの作業を続けるのは限界だ」と訳していた。意味が逆を向いている。
- QAT 版に替えると、その文の骨格は正しくなった。ほかの 40 文中 30 文は、Q4_0 版と一字一句同じだった。
- どのモデルも、
dry run(本番前の予行演習)を「テスト走行」と訳した。全員そろって車を走らせた。
言い過ぎないように、限界も書く。採点したのは 1 人で、文は自作だ。内蔵エンジンの QAT 版と Ollama を、直接伏せて読み比べてはいない。言えるのは、「内蔵にして悪くなる材料は見つからなかった」までだ。
モデルは、あれば借りる。無ければ落とす
内蔵エンジンを作ったら、次はモデルの置き場の問題になる。14.4 GB のファイルを、アプリを入れた全員に落とさせるのか。すでに持っている人にも。
ありそうな場所を、順番に見に行く
最初の試作では、アプリのフォルダと、Hugging Face のキャッシュの 2 か所だけを探していた。それを見た俺が言ったのが、これだ。
管理人ていうか、データーファイルがありそうなところを全部探るみたいなことは無理?
ローカルで LLM を動かす道具は、いくつもある。人によって入れているものが違い、モデルの置き場所も違う。
管理人人の環境によって置き場所結構違いがあるやんね
そこで、推奨モデルを次の順に探すようにした。
- このアプリのフォルダ
- Hugging Face のキャッシュ(今の llama.cpp も、ここに取得する)
- Ollama の置き場
- LM Studio のフォルダと、llama.cpp の以前のキャッシュ
家の本棚にあるのに気づかず、同じ本をもう一冊買ってしまうことがある。防ぐには、本棚にあるのが同じ本だと見分けられればいい。調べてみると、Hugging Face のキャッシュと Ollama は、ファイルの中身から計算したハッシュ(SHA-256)を、そのままファイル名にしていた。名前を見るだけで、同じファイルだと確定できる。フォルダを歩き回る必要もない。LM Studio のように、ファイルを元の名前で置く道具は、名前とサイズで探す。
どこにも無ければ、画面に「ダウンロード(14.4 GB)」のボタンが出る。途中で止めても、もう一度押せば続きから再開する。終わったらサイズとチェックサムを確かめて、合わないものは使わない。
設定画面では、こう見える。
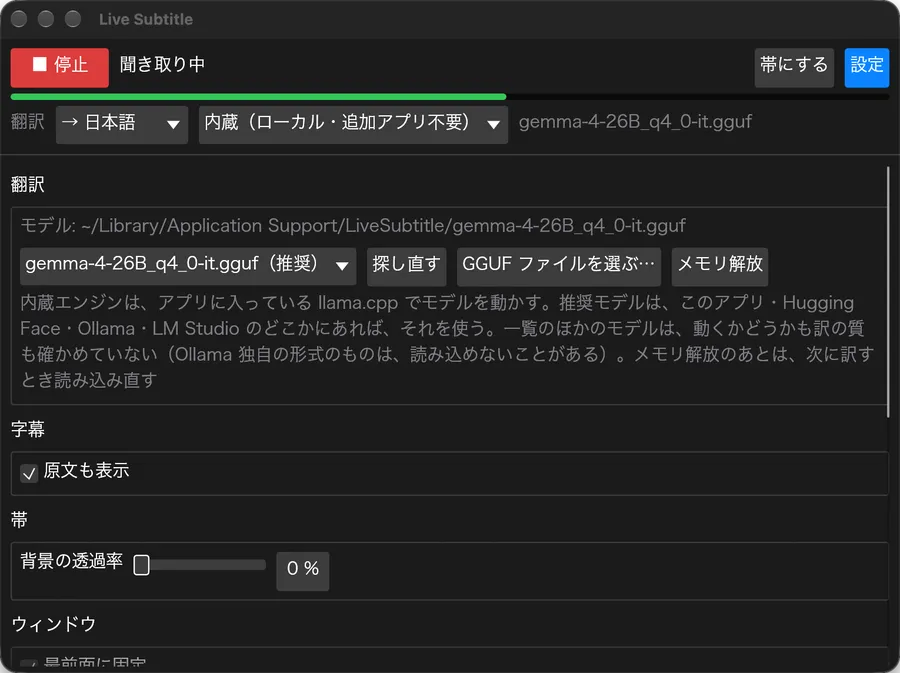
一番上に、今使っているモデルの場所が出る。その下のメニューには、推奨モデルのほかに、Mac の中で見つかった別のモデルも並ぶ。
借りられるモデル、借りられないモデル
メニューに並ぶからといって、全部が動くわけではない。俺の Mac の Ollama が持っていたモデルで、実際に試した。
- 動いた: Ollama が Hugging Face から取得したモデル。25 GB ある Gemma 系のモデルが、14 秒で読み込めて、ちゃんと訳した。
- 動かなかった: Ollama 自身が配っている
gpt-oss:20b。「unknown model architecture: ‘gptoss’」というエラーで、読み込みに失敗した。Ollama が自分の書式で作り直したファイルで、本家の llama.cpp には通じない。 - そもそも並ばない: Ollama の MLX 版(
gemma4:26b-mlxなど)。GGUF 形式ではないので、最初から対象外にしてある。
見た目は同じ GGUF なのに、試すまで動くか分からない。なので、メニューのほかのモデルは勝手には使わない。選んでもらい、読み込めなければ、サーバーが出したエラーを赤い字でそのまま見せる。
皮肉なことに、俺の Ollama に入っていたのは MLX 版だけだった。借りる仕組みを作った本人が、借りられなかった。14 GB は結局自分で落とした。10G LAN で。
既定を内蔵にして、Ollama には触らない
最後に、初めて起動したときの翻訳先を変えた。
管理人既定の翻訳先を内蔵に変えて
内蔵エンジンを作っても、最初に選ばれているのが Ollama のままでは、「Ollama 前提」の見た目が残る。初めて起動した人が最初に出会うのは、内蔵でなければ意味がない。以前から使っている人の設定は、そのまま残る。
既定を変えたら、別の問題が見えた。このアプリは、起動時と終了時に、Ollama が持っているモデルを全部メモリから降ろしていた。大きなモデルが居座るのを防ぐためで、Ollama が既定だった頃は筋が通っていた。しかし既定が内蔵になると、話が変わる。Ollama を別の用途で使っている人がこのアプリを開くと、関係ないのにモデルを降ろされる。隣の店の厨房に入って、勝手に火を消して回る客だ。
これも直した。翻訳先が Ollama でないときは、Ollama のメモリに触れない。翻訳先を内蔵にした状態で、Ollama にモデルを載せてから、アプリを起動して終了する実験をした。直す前のビルドではモデルが降ろされ、直したあとのビルドでは載ったままだった。
やらかしたことと、まだ分かっていないこと
ここまで、うまくいった話を並べた。うまくいかなかった話も書く。数字と機能をどこまで信じていいかは、失敗のほうに出るからだ。
計測の指示文を入れ忘れていた
速さを測った最初の回で、Claude Code は「差なしだった」と報告してきた。
クロード君差なしだった。字幕の翻訳という使い方では、Ollama の MLX 版と llama-server の GGUF 版で、1 文あたりの待ち時間は並んだ。
ところが、次に質を比べる段になって、こう言ってきた。
クロード君先に訂正を一つ。前回の速度の計測は「アプリと同じ指示文」と書いたが、実際は指示文の一部を入れ忘れていた。
アプリが翻訳先に渡す指示文には、「これは話し言葉の書き起こしだから、つなぎの言葉を省いて自然な語順で訳せ」と頼む段落がある。最初の計測では、その段落が抜けていた。Claude Code は自分で気づき、指示文を全文そろえてやり直した。この記事に載せた数字は、やり直したあとのものだ。欠けた指示文で見つけた「誤訳の例」も、条件が違うからと取り下げてきた。
じぴこ自分の計測を自分で取り下げるの、えらいですね。マスターも見習うといいですよ。
管理人俺は測る前に自信を持つタイプだから、取り下げる数字が無い。
止めても戻ってくるサーバーと、爆上がりした CPU 温度
完成したと思ったあとに見つかった不具合もある。
内蔵エンジンは、モデルの読み込みに数秒かかる。その読み込み中に「停止」を押すと、こうなっていた。読み込みを待っていた字幕の 1 行が、「サーバーが無い」と気づいて、サーバーを起動し直す。停止したはずなのに、14 GB のモデルがメモリに戻ってくる。止めても戻ってくるのは、ホラーの作法だ。
これは、Claude Code が仕上げの見直しで見つけた。サーバーを起動できるのは「開始」を押したときだけにして、字幕の 1 行からは起動できないように直した。読み込み中に止めても戻ってこないことを確かめるテストも足した。
もう一つは、俺が被害者だ。Claude と Codex を翻訳先にすると、翻訳が追いつかないとき、複数の行を並行して訳す。内蔵エンジンは 1 行ずつだ。それが気になって、口に出した。
管理人これさ、codex claudeは並列処理できるやん。翻訳が追いつかない時ね
Claude Code は、内蔵エンジンでも並列が効くかを測り始めた。12 文をまとめてモデルに投げる計測を、条件を変えながら何度も回す。黙って。
管理人CPU温度が爆上がりなんだけど
クロード君それは私のせい。内蔵エンジンで並列処理が効くかを測るために、モデルに 12 文をまとめて投げる計測を回していた。すぐ止める。
白状が早い。早いのはいいが、数字は 1 つも取れていなかった。結果を最後にまとめて出す作りだったので、途中で止めたら何も残らなかったのだ。Mac を熱くして、得たものはゼロ。俺の夜中の電気代だけが実績として残った。
まだ測っていないこと、確かめていないこと
そういうわけで、内蔵エンジンの並列化は測っていない。今は 1 行ずつ訳す。1 文が約 0.75 秒で訳せているので、ふつうの会話の速さなら追いつく計算だ。10 秒以上待たされた行は、訳さず原文のまま出す。早口が続いて原文のままの行が増えるようなら、そのとき測る。Mac が熱くなっても困らない時間に。
ほかにも、確かめていない範囲がある。
- 数字はすべて、Apple M1 Max(メモリ 64 GB)の 1 台で測った。
- 訳の質は、自作の 40 文を 1 人が採点したもの。聞き取りを間違えた、実際の書き起こしでは比べていない。
- LM Studio と、llama.cpp の以前のキャッシュは、俺の Mac に実物が無い。仮のフォルダを作ったテストでしか確かめていない。
振り返ると、今回の話はどれも、俺の一言から始まっている。「ちょっと違う気がする」で内蔵エンジンができた。「速いんだろ?」で評判を測り直した。「全部探るのは無理?」でモデル探しが入った。そして「爆上がりなんだけど」で計測が止まった。最後のだけは、ただの苦情だ。
管理人このアプリの便利さと実用性の高さは記事になると思うんだ。
それで、この記事になった。英語の動画を流すと、日本語が下に出る。やっていることはそれだけだ。それだけのことが、ほかに何も入れなくても動くようになった。
SWELL - シンプルなのに、高機能 – もっと気軽に、楽しく記事を書こう。 それを可能にするWordPressテーマです。
SWELLはGPL100%のWordPressテーマです。
ライセンス制限がなく、複数サイトで使えます。