AIオーケストレーションは親でケチるな
PR
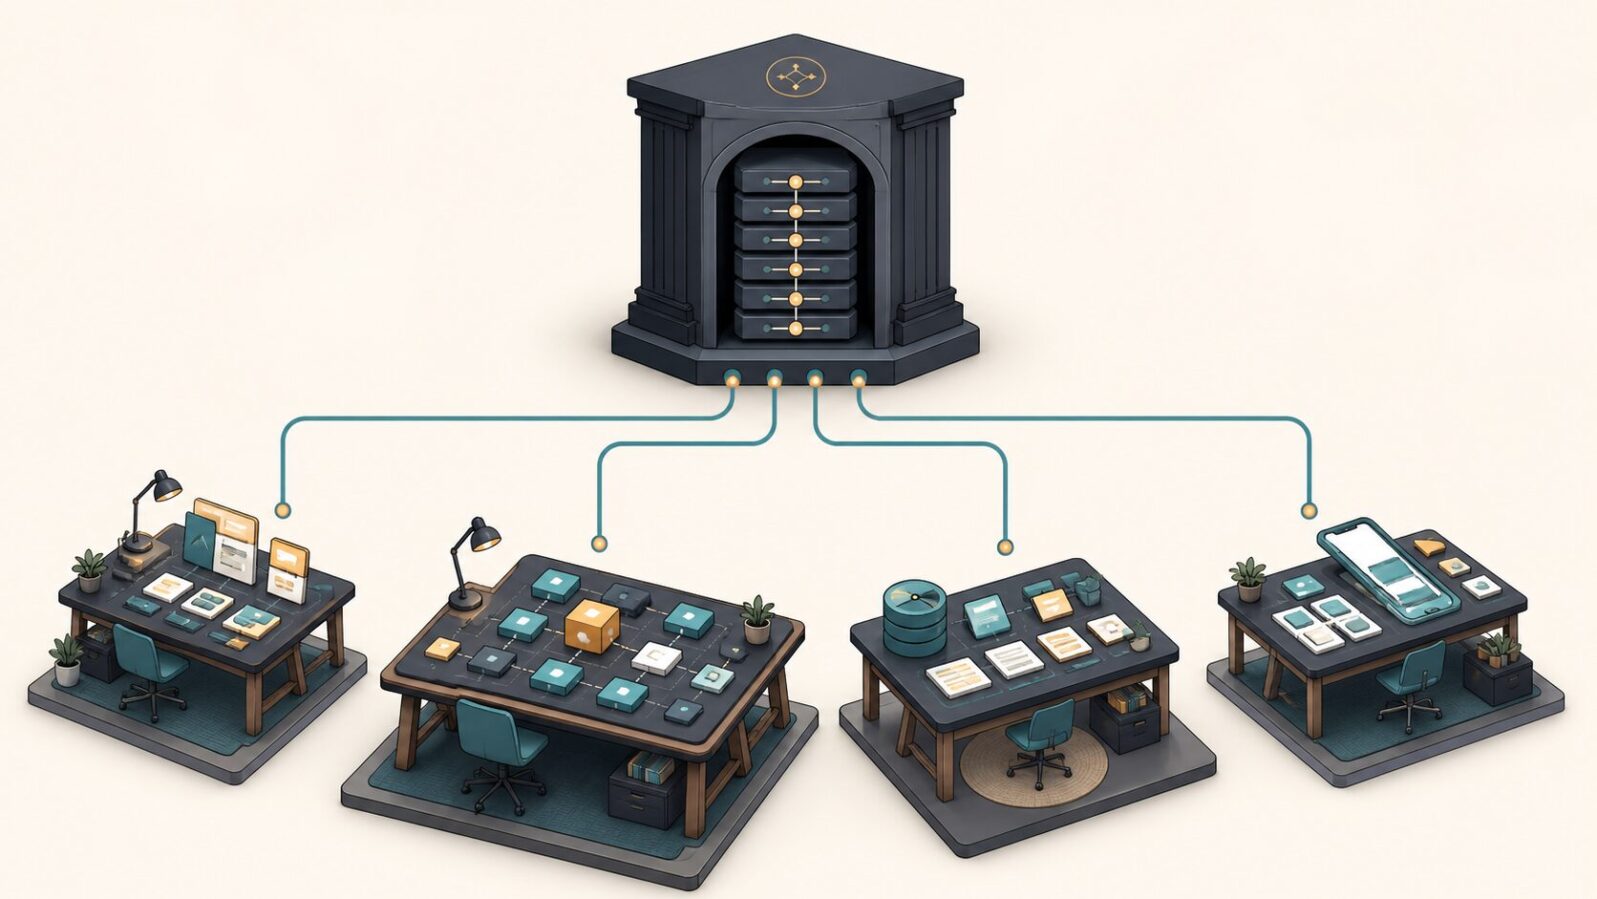
AIエージェントを複数動かすとき、計算資源をどこへ投じるべきか。私の結論は明快だ。AIオーケストレーションでは、親の思慮深さをケチってはいけない。節約するなら、境界の明確な局所作業へ無差別に最大推論を与える部分である。
ただし、この原則が発火するのは、親が目的の再定義、課題分解、成果物の採否、停止判断を担い、その一度の誤りが複数のworkerへ波及する運用だ。影響度の小さい単発処理や、結果を機械的に検証できる仕事なら、親も含めて軽くできる。ここでいう「親」は役職名ではなく、誤りの影響半径が大きい意思決定層を指す。
調査、実装、検証を担うworkerには、仕事の曖昧さ、影響度、可逆性、検証可能性に応じて推論資源を配る。一方、下流全体の方向を変える判断には最も深い推論を優先する。上流の一度の誤判断が、下流の十個の正確な作業を無駄にし得るからだ。
私はCodexのUltra相当の運用で、再帰的なループを約24時間動かしたことがある。筆者としては大きな逸脱を感じず進んだ体験だったが、タスク種別、開始・完了条件、介入回数、失敗・再試行数を揃えた記録は本稿で提示できない。したがって、この体験はUltraの一般的優位や内部構成の証明ではなく、「長時間運用の安定性を何で測るべきか」という検証仮説の出発点として扱う。
本稿で比べる主役は、公式Ultraを完成品として使う道、Sol Maxを高推論の親に置く自作Agent Runnerの道、両者を境界付きで併用する道である。動的配分の必要性、観測性、保守余力、失敗影響、同種タスクの反復性という五軸から、あなたが自分の運用を仮選択できる形にする。Fable・Mythosは製品の勝敗を約束する比較柱ではなく、確認済みの証拠だけで競合を評価する方法を試す補助例として扱う。
重要なのはモデル名の応援合戦ではない。正答率、手戻り、完了時間、障害回復、総費用まで含む生産効率で判断することだ。あなたが持ち帰るべきものは、特定製品への忠誠ではなく、親とworkerへ推論を配るための運用原則である。

contents
AIオーケストレーションで「親をケチる」と何が起きるのか
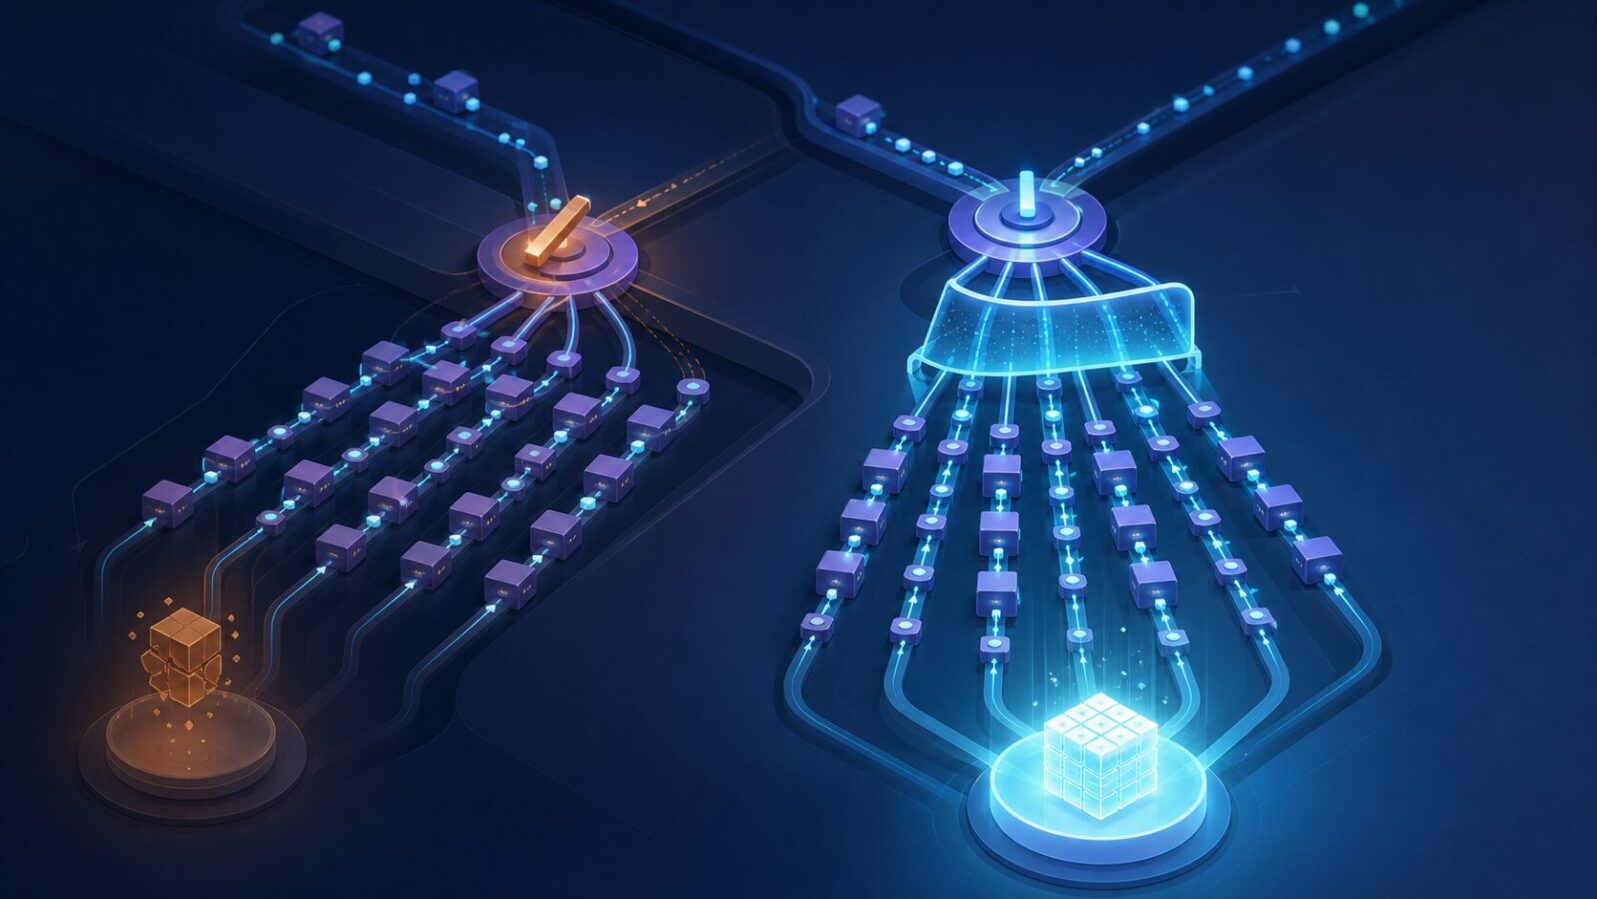
オーケストレーションの品質は、workerの平均的な賢さだけでは決まらない。より強く効くのは、親が「何を解くのか」「どこまでを一つの仕事とするのか」「どの結果を採るのか」を正しく決められるかである。親を軽くしすぎると、局所的には正しい成果が大量に並ぶ一方で、全体としては目的から外れた状態が起きる。
親は命令を配るだけのdispatcherではない
親を単なるdispatcherとして捉えると、仕事は「分割して配信し、返答を連結する」ものに見える。しかし実務の難所は、配信そのものではない。依頼文に潜む曖昧さを見つけ、隠れた前提を疑い、相互依存を切り分け、受理条件を作り、途中で前提が崩れたら計画を変えることにある。
人間のプロジェクトで考えると分かりやすい。経験の浅い進行役が、優秀な専門家へ曖昧な依頼を配ったとする。専門家は与えられた範囲で立派な成果を出せる。しかし、目的の定義や責任分界が間違っていれば、成果は一斉に同じ方向へ外れる。AIエージェントでも、局所能力が上流判断を自動的に救うわけではない。
高推論の親は、作業者より偉い存在というより、誤りの影響半径が大きい判断層である。たとえば「これは実装問題だ」と早合点すれば、本当は入力データや観測方法に原因があっても、複数のworkerがコード修正へ向かう。「調査と実装は独立」と誤認すれば、古い前提の調査結果を使って実装が進む。親の役割は、こうした誤配線を着手前と進行中に見つけることだ。
上流の誤判断は全workerへ増幅する
親の失敗が恐ろしいのは、誤差が一つの出力で閉じない点にある。分解が間違えば、すべてのworkerが不足した文脈で動く。受理条件が弱ければ、見た目だけ整った成果を通す。統合方針が誤っていれば、個別に正しい変更同士が衝突する。停止条件がなければ、改善しているように見える再試行が延々と続く。
この構造では、各workerを一段ずつ賢くするより、親の一つの誤判断を防ぐほうが大きな価値を持つ場合がある。仮に十個のworkerが九割の確率で局所タスクを成功させても、親がそもそも間違った問題を十個に分けていれば、期待する成果には届かない。逆に親が問題を正しく狭めれば、単純な検索、差分確認、テスト実行などは軽いworkerでも十分に役立つ。
ここで押さえるのは、誤りが下流へ増幅する因果である。親が担う責務は七つの判断として、安全策は最後のH2で分けて扱う。親を強くすることと、親を無条件に信じることは同義ではない。
節約対象は思慮深さではなく無差別な計算である
トークン消費だけを見ると、親を最大級の推論へ置く設計は高価に見える。しかし、単純な消費量は最終的なコストではない。誤った分解による全workerのやり直し、見落とした依存関係による回帰、終わらない再試行、人間による原因究明まで含めると、安い親が高くつくことは珍しくない。
節約すべきなのは、境界が明確な全タスクへ一律に重いreasoningを与えることだ。指定ファイルの存在確認、既知の形式への変換、決められたテストの実行、候補一覧の収集など、成功条件が機械的に確認できる仕事は軽くできる。一方で、曖昧な要求の解釈、横断設計、複数仮説の反証、不可逆な変更の採否は軽く扱わない。
中心原理
つまり、目指すのは「親もworkerもMax」ではなく、親は高推論、workerは選択的昇格という非対称な配分である。この非対称性こそが、品質を落とさずに無差別な計算を減らす中心原理になる。
UltraとMaxを公開仕様・体感・未知に分けて読む
UltraとMaxを論じるとき、最初に必要なのは強い形容詞ではなく証拠の仕分けである。公開資料で確認できること、実際に使って観測したこと、そこから推論した設計仮説、まだ分からないことを分離する。この線を崩すと、よい体験が内部仕様の断定へ化け、製品名の違いが万能な性能差の証明へ化ける。
公開資料から言えるMaxとUltraの範囲
公開上、MaxとUltraは同じ表示名ではなく、異なる位置づけで案内されている。Ultraは高い推論だけでなく、複雑な仕事を委任して進める運用と結び付けて説明される。一方、公開説明から直接読める機能と、内部で親・子へ実際にどの程度の推論資源が割り当てられるかは別問題だ。名称の差から、親の推論深度や内部モデル構成まで推定してはいけない。
また、公式のsubagent機能には、実行時のspawnで見える制御と、あらかじめ定義するcustom agent profileの制御がある。観測できるspawn surfaceに、呼び出しごとのchild modelやreasoning effortが見えない時点があったとしても、それだけで「Codexでは子agentを差別化できない」とは言えない。事前設定したprofileでモデルや推論方針を分けられる範囲と、実行時に動的変更できる範囲は、分けて確認すべきだ。
公開時点で再確認
ここは更新されやすい領域でもある。モデル名称、UltraとMaxの説明、spawn引数、profileの継承規則は、記事公開時点の公式資料と実際のsurfaceで再確認する必要がある。本稿の設計論は、その細部が変わっても残る。重要なのは「観測できる制御だけを事実として扱い、見えない内部配分を想像で埋めない」という態度だ。
24時間ループは検証仮説を生んだ一次体験として置く
私がUltra相当の運用で約24時間の再帰的ループを回したとき、筆者としては大きな文脈逸脱を感じず、目標へ向かって進み続けた。ここで確認できるのは、継続時間と筆者の自己観測までである。第三者検証済みの結果でも、別構成との比較試験でもない。
一方、この記事で提示できる記録には、タスク種別、開始状態、完了条件、人間の介入回数、失敗・再試行数、最終成果の不具合数が揃っていない。そのため「極めて正確だった」「他の構成より安定していた」と、編集上検査できる比較結果として扱うことはできない。Ultraの親がMaxと同じ深さで考えた、すべてのタスクで同じ結果になる、他の構成より必ず安い、といった結論も導けない。
この一次体験の役割は、次の検証項目を作ることに限る。次回は、入力と受理条件を開始時に固定し、逸脱、差し戻し、再試行、人間介入、完了時の残存不具合を時系列で記録する。同じ成果条件でUltra単独、自作runner、併用を比べて初めて、体感を運用判断へ進められる。
Ultra内部の親推論配分は未知として残す
高性能モードを使うと、内部の各工程まで同じ強度で動いているように想像しやすい。だが、外から見えない配分は未知である。親が常に最大推論なのか、子が仕事ごとに変わるのか、監督処理が別にあるのかを、出力の良さだけから断定することはできない。
この未知は欠点ではなく、製品と自作基盤の責任分界を決める材料になる。内部配分を自分で知らなくても完成品として高品質に動けばよいなら、Ultraの抽象化は価値がある。反対に、workerごとの推論資源、昇格理由、停止条件、再試行履歴を自分で観測し、実験したいなら、自作runnerへ寄せる理由が生まれる。
製品評価で大切なのは、未知を弱点として攻撃することではない。未知を未知のまま残し、それでも意思決定できる評価軸を持つことだ。成果品質、完了時間、介入回数、回復可能性、費用を計測できれば、内部実装を推測しなくても運用を比較できる。
高推論の親が担う七つの高影響判断
親へ深い推論を与える根拠は、仕事量ではなく判断の影響度にある。親は最も多くのコードを書く必要も、最も多くのページを読む必要もない。その代わり、下流の方向を変える七つの判断を担う。ここを明示すると、どの処理を親に残し、どこからworkerへ委任するかが見えやすくなる。
曖昧さの検知と目的の再定義
第一の判断は、曖昧さを検知することだ。「速くして」「安全にして」「よい感じに直して」といった依頼には、評価基準が欠けている。親は言葉をそのまま作業名へ変換せず、何が改善すれば成功なのか、何を変えてはいけないのか、誰が結果を使うのかを確定する。
第二は、目的を再定義することである。表面上は「テストを通す」が依頼でも、本当の目的は仕様に合う挙動の回復かもしれない。エラーを握りつぶして緑にするのは、表面目標には合っても目的には反する。高推論の親は、要求文、現状、制約の不一致を見つけ、workerへ渡す前に解くべき問題を言い直す。
課題分解と委任先の選択
第三は、課題分解である。よい分解は、単に作業を細かくすることではない。入力と出力が明確で、他の作業と同時に進められ、単独で受理できる境界を作る。逆に、同じファイルを複数workerへ同時に書かせたり、調査結果が出る前に実装を確定させたりすれば、並列化は速さではなく競合を生む。
第四は、委任先の選択だ。検索、比較、再現、実装、レビューでは必要な能力が違う。さらに同じ実装でも、既知パターンの局所変更と、複数領域をまたぐ設計変更では必要な推論が違う。親は「空いているworker」へ渡すのではなく、仕事の曖昧さ、影響範囲、検証可能性に合うworkerを選ぶ。
途中監視とworkerからの異議
第五は、途中監視である。監視は逐一口を出すことではない。前提が崩れた兆候、所有範囲の逸脱、同じ失敗の反復、成果物と報告の食い違いを見つけることだ。長い仕事ほど、完了時だけを見るより、少数の意味あるチェックポイントを置くほうが回復しやすい。
ここで親が担うのは、workerからの異議を失敗報告として処理せず、前提を再検討する入力として受け取る判断である。入力不足、所有範囲の衝突、受理条件の矛盾が示されたら、親は進行継続か再分解かを決める。異議経路の具体的な作り方は、最後のH2で扱う。
競合仮説の反証と成果物の採否
第六は、競合仮説を反証することだ。不具合の原因を最初の一案へ固定せず、実装、入力、環境、観測、要求解釈など複数の説明を並べ、どの確認で棄却できるかを決める。workerへ仮説別の調査を任せる場合も、親は多数決ではなく証拠の強さで統合する。
返答が流暢であることと、成果物が正しいことは別だ。親は要約の説得力ではなく、差分、テスト結果、生成物、再現手順などを見て採否を決める。ときには「完了した」という報告を退け、ときには途中でも目的を満たした成果を採る。この採否判断こそ、高推論を使う価値が大きい。
再統合と停止判断
第七は、再統合と停止判断である。複数workerの成果は、単純に連結すればよいとは限らない。用語、前提、データ形式、責任範囲が一致しているかを確認し、全体の目的へ戻して組み直す必要がある。局所最適同士がぶつかるなら、親が優先順位を決める。
停止判断
停止も立派な判断だ。追加の探索が結論を変える可能性はあるか。残る不確実性は許容できるか。再試行が同じ失敗を繰り返していないか。完璧を求めるあまり総コストが膨らんでいないか。開始より停止のほうが難しい仕事は多い。だから、停止条件を後付けせず、委任前の受理条件と一緒に定める。
workerの推論資源は選択的昇格で配る
親へ高推論を集中しても、workerを一律に軽くすればよいわけではない。軽量workerが向く仕事と、上位推論へ昇格すべき仕事を見分ける必要がある。発想はオートスケーリングに似ているが、推論品質はCPU使用率のような一つの数値では決まらない。曖昧さ、影響度、可逆性、検証可能性を組み合わせて判断する。
境界が明確な調査・実装・検証は軽くする
軽量workerへ渡しやすいのは、入力、出力、禁止事項、受理条件が明確な仕事だ。たとえば指定範囲のログから時刻順の事実を抜く、二つの設定ファイルを比較する、既知の関数へテストを追加する、決められたコマンドを実行して結果を返す、といった作業である。
これらは「簡単だから軽くする」のではない。誤りを外部から発見しやすいから軽くできる。結果が不正ならテストや形式検証で止められる。変更範囲が狭ければ差し戻しも容易だ。親が境界と受理条件を丁寧に作るほど、worker側の推論を必要以上に重くせずに済む。
一方、単純に見えても、仕様が曖昧なデータ変換、外部状態を変える操作、失敗が静かに残る作業は軽量向きとは限らない。行数や作業時間ではなく、誤りの発見可能性と影響半径で分類するべきだ。
曖昧さ・横断設計・高影響変更を昇格させる
上位推論へ昇格する兆候は、事前にルール化できる。代表的なのは次のような場面だ。
- 要求に複数の妥当な解釈があり、選択で成果が大きく変わる
- 複数のコンポーネント、データ、契約をまたぐ設計判断が必要になる
- 原因仮説が競合し、最初の説明を反証しなければならない
- 変更が不可逆、外部送信、権限、課金、公開などの高影響境界に触れる
- workerが親の前提と矛盾する証拠を見つけた
- 検証方法そのものを設計しなければ、正誤を判定できない
- 同じ失敗が繰り返され、現在の問題設定を疑う必要がある
昇格は失敗への罰ではない。仕事の性質が変わったことへの資源再配分である。最初は軽量workerへ渡せる調査でも、矛盾が見つかった瞬間に横断設計問題へ変わることがある。固定的な担当ではなく、観測に応じてreasoningを上げ下げする仕組みが必要だ。
一律低推論と一律最大推論の両方を避ける
一律低推論は、上流の誤りと難所の見落としを増やす。一律最大推論は、境界明確な仕事まで重くし、待ち時間と消費を膨らませる。さらに、すべてが同じ強度だと「どの判断にコストを使ったのか」が見えにくくなり、改善実験も難しくなる。
実務では、四軸をまとめて次のように初期配置を決める。この表は数値閾値ではなく、自分の運用に合わせて境界を置くためのrubricであり、どれか一軸だけで機械的に決めるものではない。
| 仕事の状態 | 曖昧さ | 影響度 | 可逆性 | 外部検証可能性 | 初期配置 |
|---|---|---|---|---|---|
| 形式的に受理できる局所作業 | 低い | 小さい | 高い | 高い | 軽量worker |
| 複数解釈がある限定作業 | 中程度 | 限定的 | 中〜高 | 検証設計が必要 | 上位workerまたは親へ昇格 |
| 全体設計・不可逆変更・外部境界 | 高い | 大きい | 低い | 事後検証では遅い | 親が判断し、外部送信・公開・権限・課金の前で人間確認へ停止 |
この分類はモデル名へ固定しない。たとえば曖昧な不具合修正なら、親が実装・入力・環境の競合仮説と受理テストを定め、軽量workerが仮説ごとの証拠を集める。証拠が親の前提と矛盾したら上位判断へ戻し、修正候補はvalidatorと合格テストで採否する。固定的なモデル名ではなく、この遷移を設計するのが選択的昇格である。
総トークンではなく総コストで評価する
推論配分の評価を総トークンだけで行うと、誤った節約へ向かいやすい。見るべきなのは、少なくとも次の六つである。
| 評価軸 | 観測するもの |
|---|---|
| 正答率 | 受理条件を一度で満たした割合 |
| 手戻り | 再実装、再調査、差し戻しの回数と規模 |
| 完了時間 | 待ち時間、人間の介入時間を含む終端までの時間 |
| 障害回復 | 中断後に同じ証拠から安全に再開できるか |
| 計算消費 | 入出力トークン、推論時間、並列数 |
| 総費用 | モデル利用、人間作業、失敗の影響を合わせた費用 |
表を自分の計測へ移すには、比較単位を「同じ入力から、同じ受理条件を満たす一つのタスク」へ固定する。たとえば一件の不具合修正を比べるなら、同じ基準コミット、同じ再現手順、同じ合格テストを各ルートへ渡す。開始は依頼時、終了はテスト通過だけでなく差分が受理された時点とする。
| 記録点 | 残す内容 |
|---|---|
| 開始 | 入力版、運用ルート、受理条件、許可ツール、並列条件、人間介入ルール、停止条件。揃えられない条件は差分として明記 |
| 初回受理 | 一度で通ったか、差し戻し理由 |
| 介入 | 人間が行った判断と所要時間 |
| 復旧 | 中断地点、再開に使えた証拠、やり直した範囲 |
| 終了 | 完了時間、計算消費、残る不具合 |
不可逆境界
平均値とは別に、最大失敗影響と、人間の停止境界を越えた回数も記録する。外部送信、公開、権限、課金などの不可逆境界は、低い平均費用で相殺しない。
この記録なら、トークンが少なくても差し戻しと人間介入が多いルートを「安い」と即断せずに済む。反対に、高推論の親が消費を増やしても、初回受理率を上げ、復旧範囲を狭めたなら、その追加計算を総費用の低下として評価できる。次のH2では、この同一タスク計測を前提に三つの運用ルートを分岐させる。
公式UltraとSol Max自作runnerをどう使い分けるか
公式Ultraと自作runnerは、単純な上下関係ではない。完成品へ責任を寄せるのか、推論配分と観測性を自分で設計するのかという違いである。本稿では、筆者が自作Agent Runnerの高推論親として使う構想を便宜上「Sol Max」と呼ぶ。これは公式製品名や内部構成について新しい断定を加える呼び方ではない。
まず、次の五軸で仮選択する。この表は製品性能の事実比較ではなく、あなたの運用要件を分けるための判断表である。
| 運用ルート | 動的配分の必要性 | 必要な観測性 | 保守余力 | 失敗影響の扱い | 反復性・配分ルールの再利用 |
|---|---|---|---|---|---|
| Ultra単独 | 利用者が配分を細かく設計する必要が低い | 最終成果、介入、所要時間を測れればよい | runner基盤を持ちたくない | 一つの主経路へ寄せ、人間の確認点を置く | 単発タスクの基準線に向く |
| Sol Max自作runner | 証拠に応じてworkerを昇格・変更したい | 昇格理由、停止履歴、採否まで追いたい | 状態管理、検証、復旧を保守できる | 変更範囲を狭め、ロールバック可能にする | 同じ不足が再発し、配分ルールを次回へ再利用したい |
| 境界付き併用 | 一部工程だけ配分を制御したい | 経路間の入力、成果物、採否を追いたい | 境界部分だけなら保守できる | 主経路と最終採用権を一つに固定する | 反復工程と曖昧な難所を分けて再利用したい |
成果物を早く得ることが目的で、runnerの改善自体は目的でないなら、まずUltra単独を基準線にする。推論配分の実験と可観測性そのものが目的で、基盤を保守できるなら自作runnerを選ぶ。反復工程は自作側で固定し、曖昧な難所だけ別経路へ上げたいなら併用が候補になる。ただし併用は、二つの親へ同じ採用権を与えないことが前提だ。
Ultraを強力な完成品として使う条件
Ultra単独が向くのは、まず成果を得たい、runner基盤の開発自体を目的にしていない、細かな推論配分より一貫した運用を優先する場合だ。オーケストレーション基盤のテスト、状態管理、障害回復まで自分で背負う余力がないなら、完成品へ責任を寄せる判断には合理性がある。
評価は高性能という呼び名ではなく、同じ受理条件で行う。最終成果、再試行、人間の介入、復旧を測り、完成品が手戻りを減らしたかを見る。内部配分を知らないことが許容できるかも、このルートを選ぶ条件になる。
自作runnerで動的配分と観測性を得る条件
自作runnerの価値は、モデルを呼べることではなく、どの判断を誰へ渡し、なぜ昇格し、どこで止めたかを自分で設計できることにある。軽いworkerへ境界明確な作業を渡し、矛盾や高影響境界が見つかったときだけ上位推論へ移す。成果物と採否理由を残せば、配分そのものを改善対象にできる。
自由度は保守責任と表裏一体だ。所有範囲、状態競合、途中失敗からの再開、二重採用、停止不能を基盤側で扱う必要がある。「モデルを節約できそう」だけでは選択理由にならない。観測したい指標、変えたい配分、検証方法が具体的であり、その基盤を維持できる場合に候補になる。
spawn surfaceとcustom agent profileを混同しない
実行時のspawn surfaceに見える制御と、事前に定義するcustom agent profileの制御は分けて考える。呼び出しごとにchild modelやreasoning effortを指定できるかという問いと、役割別profileへ設定を持たせられるかという問いは同じではない。
ここは更新されやすく、公開時点の公式資料と現在のtool schemaで再確認が必要である。観測したsurfaceにない引数を存在すると仮定せず、同時に、見えないことを公式機能全体の恒久的な不可能へ広げない。必要なのが事前構成か、実行中の動的変更かを先に決めてから比較する。
単独運用より併用が合理的な場面
併用が合理的なのは、責任境界を一文で言える場合だ。たとえば、反復的で機械検証できる工程を自作runnerの主経路へ置き、横断判断だけ別経路へ昇格する。逆に、Ultraを主経路にし、計測したい限定工程だけ自作側へ出す構成も考えられる。
併用の境界
難所は、どちらが最終判断を持つかである。二つの親が同じ成果物を更新すれば、観測性より競合が増える。主経路、昇格条件、採用権限、失敗時の戻り先を一つずつ固定できないなら、併用ではなく単独ルートから始めるほうがよい。
Fable・Mythos比較はモデル勝負より生産効率で測る
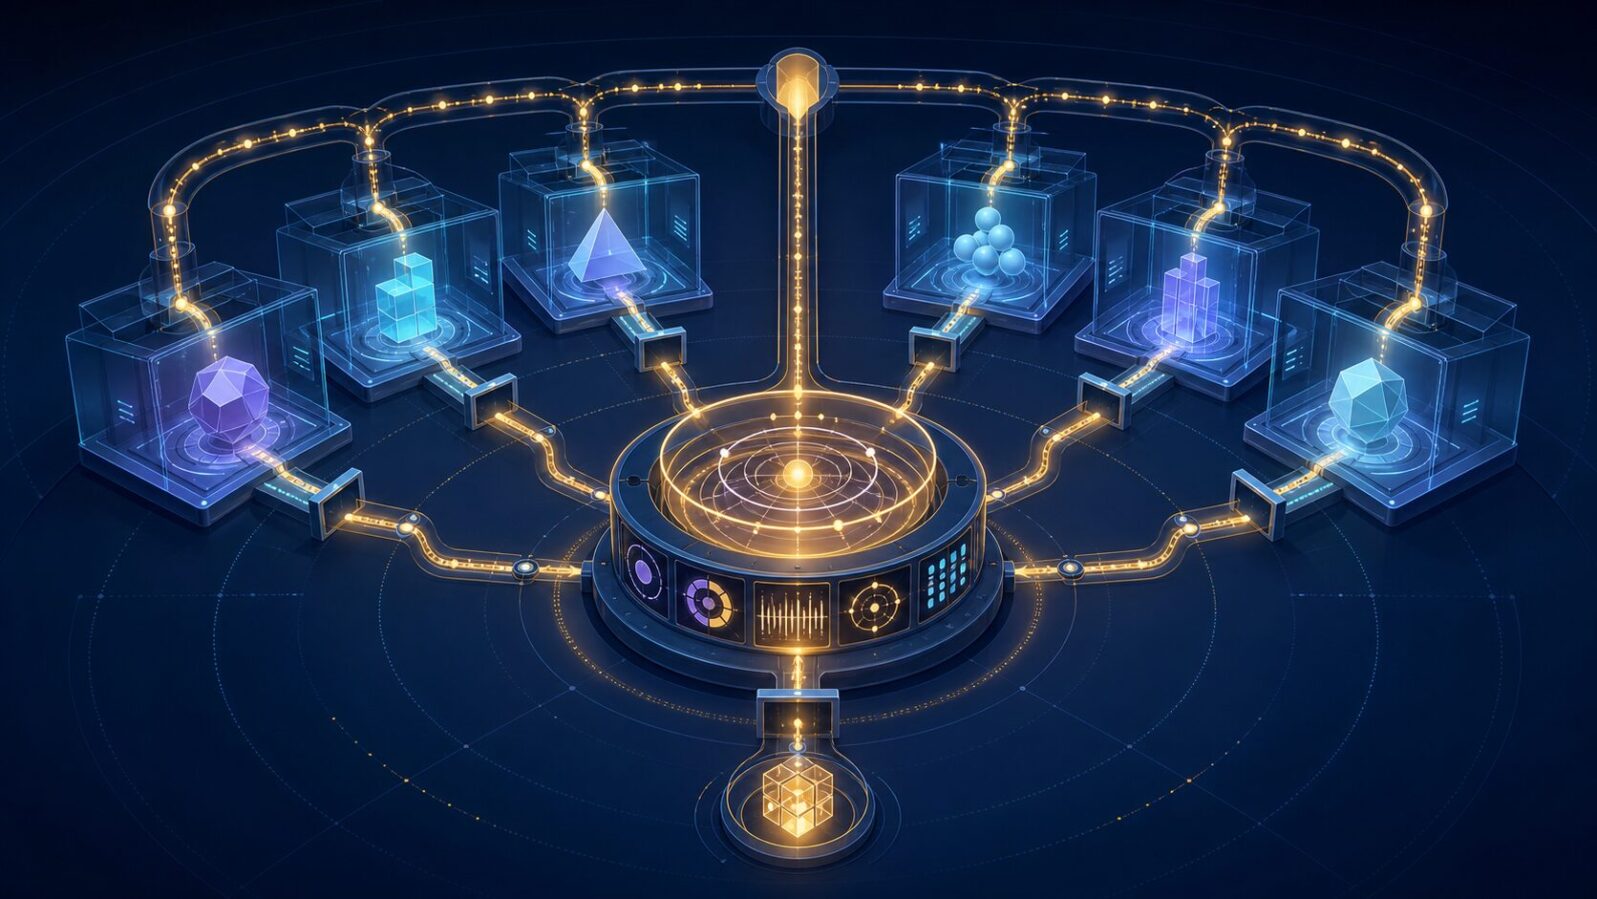
Fable・Mythosは、本稿でUltraや自作runnerと同格の比較柱には置かない。現時点で本稿に載せられる、評価日、対象版、条件、結果を揃えた確認済み比較行がないためだ。この節では性能差や採用結論を出さず、競合名を例に「何が揃えば比較してよいか」だけを定める。
確認済みの比較行だけを同じ表へ置く
比較行には、agent名だけでなく、対象版、評価日、問題集合、利用ツール、制限時間、試行回数、成功判定を付ける。SWE-Bench Pro、ExploitBench、Toolathlonのように測る能力や条件が異なる評価は、数値が並んでいても同じ順位表へ足し合わせない。各行が何を測ったかを先に固定する。
Fable 5とMythos 5の名称、基盤、安全策、提供条件の関係も、一次資料を確認するまで役割を割り当てない。「軽量版」「安全版」「上位版」といった説明を空欄の代わりに置くと、比較の前提を作り話で埋めることになる。確認できない欄は未確認のまま残し、相手が強い反例も同じ条件で採用する。
出力トークン・所要時間・費用を同じ完了条件で測る
成功率だけでは生産効率を選べない。同じ入力と受理条件に対して、所要時間、入出力トークン、再試行、人間介入、推定費用、失敗時に残る成果を記録する。大量に探索して回帰を防いだ構成と、短く終えたが人間の修正を要した構成を、出力トークンだけで比較しない。
費用は固定値として断定せず、モデル単価、並列数、キャッシュ、ツール実行、人間の確認時間という前提を添える。前のH2で定めた同一タスクの記録形式へ載らない数字は、採用判断ではなく参考値に留める。
モデル性能とシステム探索を分ける
一つの推論主体が深く解く能力と、複数の探索、実装、検証、批判を統合するシステム能力は別の軸である。単発モデルの得点だけでは横方向の探索コストと回収利益を測れず、複数agentの最終成功率だけでは一つの主体の推論力を切り出せない。
確認済みの比較行
したがって、確認済みの比較行が揃うまでは「Sol MaxがFableやMythosに勝つ」「あるベンチマークで勝ったから全用途で上」といった結論を置かない。Fable・Mythosは、証拠条件を欠いた製品比較を止めるための補助例であり、本稿の三ルート選択は動的配分、観測性、保守余力、失敗影響から行う。
賢い親の失敗を防ぐ検証設計と実践判断
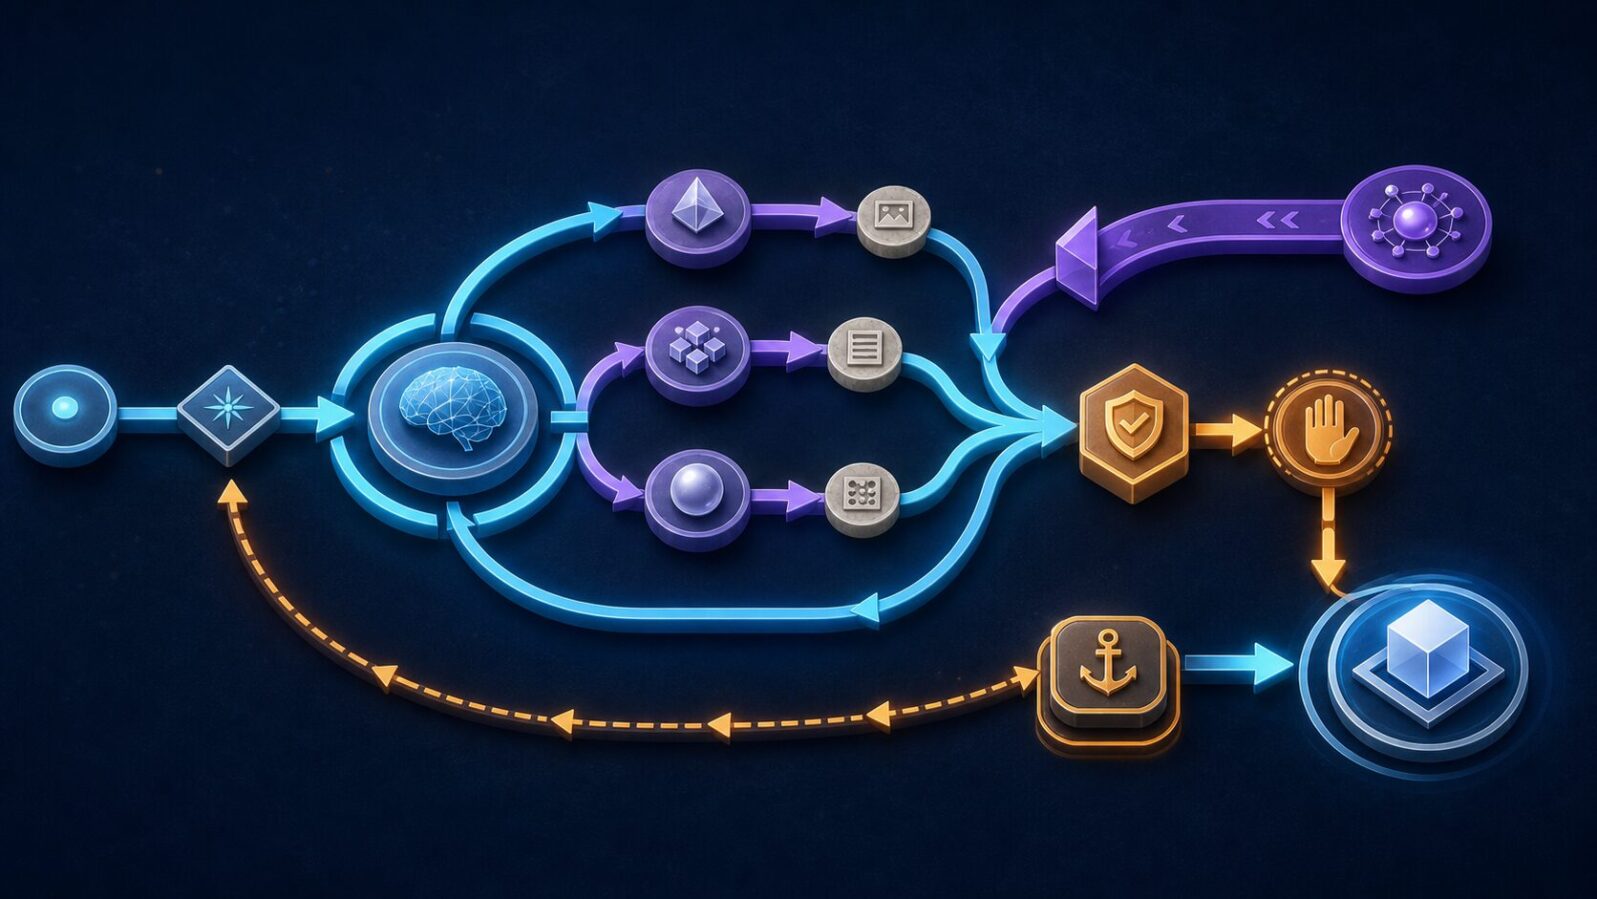
高推論の親へ資源を集中する設計には、親が誤前提へ固執し、全体の単一障害点になるという反論がある。このH2の責任は、七つの親業務をもう一度並べることではない。親の判断を、反証、成果物の受理、復旧可能な停止という三つの仕組みで拘束し、選んだ運用ルートを再点検することだ。
深く考えるほど正しいとは限らない
推論量と正しさは単調には増えない。前提が正しければ深い推論は複雑な依存を解けるが、前提が誤っていれば誤りを精緻に補強することもある。長い説明、整った計画、多数のworkerは、それ自体では正しさの証拠にならない。
親には、結論だけでなく、前提、有力な競合仮説、どの観測で判断を変えるかを出させる。たとえば「原因は実装にある」ではなく、「入力と環境の仮説をこの確認で棄却できた場合に実装仮説を残す」とする。判断を変える条件がない計画は、深くても検査できない。
思考予算にも停止条件を置く。追加調査が結論を変える可能性、失敗時の影響、検証費用を見て、次の一手が新しい証拠を生まないなら止める。高推論を優先することと、無期限に考えさせることは同義ではない。
独立批判役・競合仮説・worker異議を組み込む
独立批判役には、親の説明をきれいに言い換えさせるのではなく、目的、主要証拠、候補成果物、受理条件を渡し、欠けた前提と反例を探させる。親の長い物語をそのまま共有しないことで、同じ結論への追認を避けやすくなる。
競合仮説は、少なくとも有力な二案を並べ、片方だけが予測する観測を探す。仮説別workerの自信度や文章量ではなく、再現できる証拠で比較する。全workerが同じ入力誤りを共有している可能性も、独立性の点検に含める。
workerからの異議には、反対意見ではなく、衝突した前提、観測した証拠、続行した場合の影響を添えさせる。親は採用または棄却の理由を成果物へ残す。これで異議は抽象的な安全策ではなく、上流判断を更新する入力になる。
成果物ベースのvalidatorと停止条件を置く
完了はエージェントの自己申告ではなく、成果物から判定する。コードならテストと差分、記事なら構成と主張、変換なら入力と出力の対応、運用なら状態遷移を見る。validatorは形式、件数、順序、禁止事項、再現性を守り、解釈や採用の最終判断とは分ける。
停止条件は、「必要成果物がある」「入力との対応が取れた」「重要な反証が解消した」「残る不確実性を記した」「外部変更の前で人間確認へ止まった」のように観測可能な形へする。同じ失敗原因が続いた場合は、再試行回数を増やさず、問題設定へ戻る。
復旧条件も同時に定める。会話の記憶ではなく、入力版、候補成果物、受理結果から再開できるか。どの候補が採用済みかを重複なく判定できるか。中断後に正しい地点へ戻れない設計は、平常時の速さだけでは総コストを評価できない。
Ultra単独・自作runner・併用を選ぶチェックリスト
前の判断表で仮選択したルートを、次の三問で再点検する。
- そのルートでしか満たせない具体的な要件は何か。要件が言えないなら、基準線を複雑にしない。
- 観測したい昇格理由、停止履歴、採否と、それを保守する余力があるか。両方がある場合だけ自作範囲を広げる。
- 併用時の主経路、最終採用権、失敗時の戻り先を一つずつ言えるか。言えないなら併用境界を狭める。
成果物を得ることが第一ならUltra単独を基準線にし、同一タスクの総コストを測る。配分の改善が目的で、観測と復旧を保守できるなら自作runnerを限定工程から始める。両方が必要なら、一つの採用権を守れる境界だけを併用する。選択はブランドへの好みではなく、検証可能な運用要件から決める。
親でケチらず局所の無差別計算を減らす
親の誤りが複数workerへ波及する運用では、高影響の判断へ深い推論を置く。単発で機械検証できる仕事まで、親を常時最大化する主張ではない。
Ultra、自作runner、併用のどれを選んでも、同じ入力と受理条件で初回受理、手戻り、人間介入、復旧、計算消費を測る。Fable・Mythosを含む競合比較は、日時と条件を揃えた確認済み行ができるまで採用判断へ使わない。これで、製品仕様が変わっても判断軸は残る。
親でケチらず局所の無差別計算を減らす
親の思慮深さでケチらない。ケチるのは、局所作業へ無差別に投じていた計算のほうだ。
よくある質問
SWELL - シンプルなのに、高機能 – もっと気軽に、楽しく記事を書こう。 それを可能にするWordPressテーマです。
SWELLはGPL100%テーマです。
ライセンス制限はなく、複数サイトでご自由にご利用頂けます。
このBLOGももちろんSWELL使ってますよ!

ロリポップレンタルサーバー
筆者もこのBLOGでお世話になっているレンタルサーバー。 ハイスピードプランはLiteSpeed採用でガチで速いっすよ。
筆者もこのBLOGでお世話になっているレンタルサーバー。
ベーシックプランはガチで速いっすよ。コストパフォーマンス満足度
使い続けたいレンタルサーバー
アフィリエイト、ブログで使いたいレンタルサーバー
サポート対応満足度
すべて1位