ChatGPTを親にするCLIエージェント設計
PR
「親はClaude、実装する子はCodex」。AIコーディング界隈を眺めていると、そんな役割分担を“標準編成”のように語る場面を見かける。もちろんモデルごとに得意不得意はあるし、Claudeが親役としてうまく働くケースまで否定する気はない。
ただ、そこで「GPTを親にすると馬鹿すぎてダメ」とまで言われると、僕はいつも心の中でこうツッコんでいる。
その前に、親へ渡した案件、ちゃんと仕事として定義した?
目的も権限も変更範囲も曖昧なまま、「いい感じに分解して、いい感じに部下を動かして、最後は全部うまくまとめて」と頼んだなら、人間のPMでもだいぶつらい。AIの親適性を論じる前に、比較条件としての案件定義を揃えないと、モデル差と発注の粗さがごちゃ混ぜになる。
そんな違和感と、旧Codex.appから現在のChatGPT.appまで続く僕の偏愛を、実際に動く形へ落としたのが、公開リポジトリのCLI Agent Runnerだ。ChatGPT.appを母艦に残しながら、Codex CLIをはじめとする外部CLI workerへ、責務とスコープを持たせて仕事を渡すためのプラグインである。
この記事では「またAI軍団を作ったの?」という話ではなく、なぜモデル名より責務を先に決めるのか、なぜChatGPT.appを母艦にしたのか、そして似たOSSがすでにある中でCLI Agent Runnerの立ち位置はどこなのかを、実装と公開READMEを根拠に整理する。
先に結論を言えば、これは最強モデルを王様に据える道具ではない。好きな母艦へ、境界の決まった外部CLIプロセスを一時的に差し込む道具だ。
 じぴ子
じぴこ「AI軍団の司令官を決める記事かと思ったら、まず発注書を書けという話なんですね」
そう。地味に見えるけれど、僕はそこがいちばん効くと思っている。

contents
「親Claude・子Codex」が標準という空気への違和感
僕が引っかかっているのはClaudeでもCodexでもない。モデル名が、そのまま「親」「子」「設計者」「実装者」という役職名に変換されてしまうことだ。能力差を語ることと、役職を固定することは似ているようで別の話である。
モデル名をそのまま役職名にしていないか
親AIには、利用者との会話を保ち、目標を理解し、仕事を分け、権限を管理し、戻ってきた成果を統合し、最後に受理する役割がある。この仕事に向くモデルを選ぶのは当然だ。しかし「Claudeだから親」「Codexだから子」と先に席を決めると、案件側の設計が見えなくなる。
たとえば親へ渡す依頼が、「このリポジトリをいい感じに直して。必要ならサブエージェントも使って」で終わっていたらどうなるか。何を直すのか、どのファイルを触れるのか、誰が最終判断を持つのか、成功とは何かが空白のままだ。その状態で親が迷走した結果だけを見て「やはりGPTは親に向かない」と結論づけても、モデルと案件定義のどちらが原因かは分からない。
逆に、案件の目的、参照すべき正本、変更範囲、禁止事項、完成物、受理条件まで同じにしたうえで複数モデルを比べれば、そこで初めて推論力や計画力の差を語りやすくなる。本記事ではそのベンチマークまではしていない。僕が言いたいのは、モデル差がないではなく、案件差を放置した比較はモデル比較になりにくいということだ。
似たrepoが多いからこそ、機能ではなく作った理由を見る
この手の仕組みを考えたとき、僕自身も「世の中のエンジニアはだいたい同じことを考えているし、似た機能のrepoはたくさんあるだろうな」と思っていた。実際、その通りだった。supervisorが複数agentを動かすもの、複数モデルの回答を合成するもの、tmuxとworktreeで多数のCLI sessionを管理するものなど、公開OSSには立派な先行例がある。
だから独自性を「複数CLIを起動できます」「並列で動かせます」だけに求めると苦しい。今どき、そこは珍しい看板ではない。見るべきなのは、機能の数ではなく何を中心価値として設計したかだ。
僕が欲しかったのは、大規模なagent fleetの運営基盤でも、モデル同士を戦わせる投票所でも、長寿命sessionを大量に飼うTUIでもなかった。ChatGPT.appの親taskが利用者との関係と最終判断を握ったまま、必要なときだけ外部CLIへ、責務の輪郭がはっきりした仕事を渡せること。それがCLI Agent Runnerを作った理由であり、比較するときの軸でもある。
親AIの適性より先に、案件を仕事として定義する
AIオーケストレーションという言葉は少し大げさに聞こえるが、基本は人間の仕事の発注と変わらない。担当者のブランドを選ぶ前に、「何を、どこまで、何を根拠に、どんな状態へ持っていくか」を決める。僕が重視しているのは、モデル序列ではなく、この責務先行の設計だ。
「親GPTが馬鹿という前に、案件定義まともにした?」
人間のPMが担当者に「この機能、いい感じに作っといて」とだけ言い、翌日に成果を見て「なんで意図どおりじゃないんだ」と怒っていたら、たぶん周囲は発注側にも原因があると思うだろう。AIになると、なぜかこの当たり前が消えやすい。
案件を管理可能な仕事へ変えるには、少なくとも次の要素がいる。
- 何を達成するのかという目的
- どの情報やファイルを正本として扱うのか
- 誰が判断権と最終受理を持つのか
- 変更してよいscopeと、触れてはいけない範囲
- workerが返す完成物と、その保存先
- どの状態なら仕事を終えられるかという完了条件
CLI Agent Runnerでは、workerへ単なるpromptだけを投げない。対象repository、callerが定めたrole、task identity、機械判定できるwrite scope、具体的なassignment、expected outputを一組として渡す。つまり「何か賢いことをして帰ってきて」ではなく、「あなたはこの責務の所有者で、ここを根拠に、この範囲だけを変更し、この成果物を完成させる」と仕事を成立させてから実行する。
もちろん、これでモデル固有の能力差が消えるわけではない。長い依存関係を追う力、曖昧な要件から重要点を拾う力、実装の正確さには差が出る。それでも、比較の土台を整えないまま能力だけを論じるより、かなり建設的になる。
親が持つべきものは賢さの王冠ではなく目標と権限
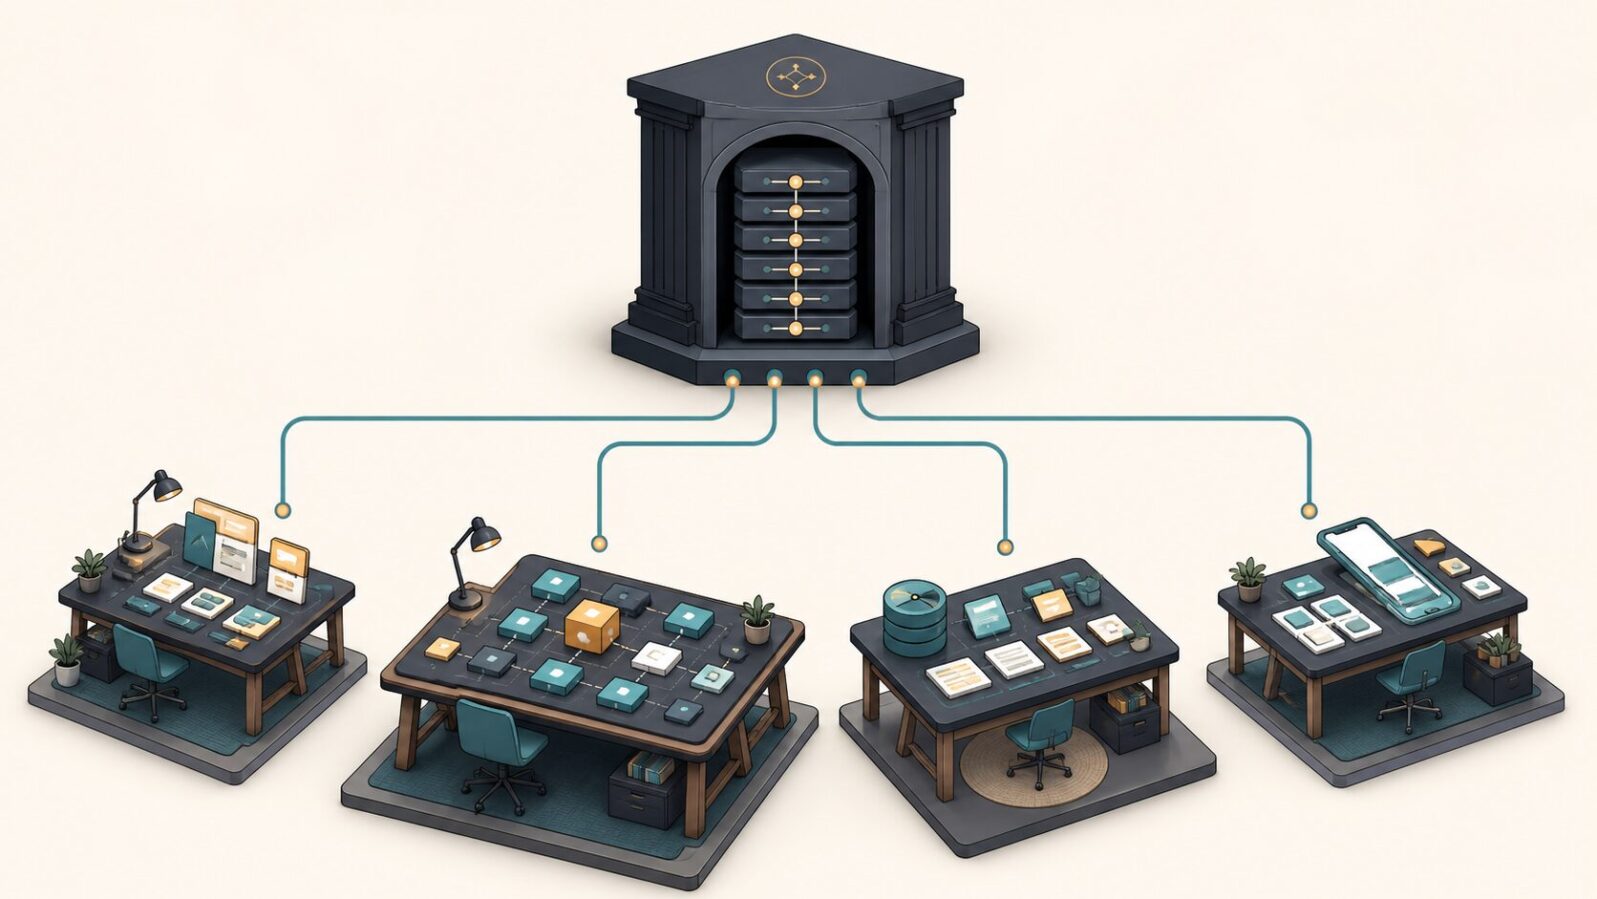
CLI Agent Runnerでいう親は、「もっとも賢いモデルに与える名誉職」ではない。親taskは、利用者の目標、トップレベルの分解、権限、同時実行数、成果の統合、最終acceptanceを持つ。子workerへ仕事を委譲しても、この所有権は移らない。
ここは重要だ。workerが自分の担当ファイルをきれいに仕上げても、全体の目的に合うかを判断するのは親である。一方、親がworkerの成果を毎回横から書き直す設計でもない。責務を渡したなら、その範囲の完成はworkerが所有する。親は境界を決め、結果を受け取り、全体へ接続する。
人間のチームで考えれば分かりやすい。プロジェクト責任者が利用者との合意と全体判断を持ち、各担当者は割り当てられた成果物を端から端まで仕上げる。責任者が全員の作業を毎回やり直すなら分業ではないし、担当者が勝手に全体方針を変えるなら統制がない。必要なのは王様と家来ではなく、所有権と境界だ。
同じ入力条件を揃えなければモデル比較にならない
「どのモデルを親にすると成功率が高いか」は、本来なら同じ案件定義、同じ権限、同じ参照情報、同じ受理条件で比べるべき問いである。片方には具体的なscopeと成果物を渡し、もう片方には会話の勢いだけで丸投げしたら、その結果は親適性の比較ではない。
しかも実運用では、モデルの外側も効く。利用できるtool、contextの渡し方、repositoryの状態、認証、timeout、並列jobの競合、失敗時の戻し先。オーケストレーションの成否は、モデル単体のIQテストではなく、仕事の設計と実行環境を含む系の結果だ。
僕はGPTを親にすれば必ず勝てると言いたいわけではない。Claudeが親として優れる場面もあるだろうし、案件によっては人間が直接CLIを操作するほうが早い。ただ、「GPT親は馬鹿」で話を終える前に、発注書を机の上へ出してみよう。その案件、誰が受けても迷子にならない形になっているだろうか。
ChatGPT.appを母艦にするという設計判断
ここからは、もう少し個人的な話になる。僕は旧Codex.app、そして現在のChatGPT.appがかなり好きだ。機能一覧だけではなく、会話を中心に仕事を組み立て、必要な能力を接続していくシステム設計そのものに惹かれている。だから新しいCLIオーケストレーターを作るために、好きな母艦を捨てる気はなかった。
旧Codex.appから新しいChatGPT desktop appへ
製品名の整理をしておくと、OpenAIは旧Codex appを新しいChatGPT desktop appへ移行し、Chat、Work、Codexを同じアプリ内の別ビューとして扱う形へ更新した。現在の記事では、この製品をChatGPT.appと呼んでいる。移行の概要はOpenAI Help Centerの案内で確認できる。
名前が変わっても、僕が母艦に残したいものは同じだ。利用者との継続した会話、前提の共有、目標の保持、判断の積み上げ、そして最終的な受理。外部CLIに強い実行能力があっても、この主対話まで丸ごと譲る必要はない。
好きなシステム設計と対話体験を手放したくなかった
道具の設計理由は、いつも市場分析だけではない。「自分がこれを好きだから」という理由は、案外まっとうだと思う。僕はChatGPTのシステム設計に魅了されている民なので(笑)、Claudeを中心に全体を組み直すより、ChatGPT.appから必要なCLI能力を呼び出したかった。
これは、気に入ったIDEを中心に置いたまま、compilerやtest runnerだけ外部processとして使う感覚に近い。IDEとcompilerの優劣を争わせるのではなく、思考と操作の中心はここ、実行能力はそこ、と役割を分ける。母艦を固定し、周辺の実行器を交換可能にすると、利用者との文脈を守りながら道具を選べる。
そして身も蓋もない話をすると、僕はClaudeを契約していない(笑)。「親Claudeを前提にしましょう」と言われても、僕の日常環境とは合わない。ChatGPT.appとCodex CLIで成立し、必要になった人だけがClaude CLIやGrok CLIを選べる設計のほうが自然だった。
外部CLIは部下というより交換可能な実行器
親子や上司部下という言葉は便利だが、ときどき人格的な序列を連れてくる。CLI Agent Runnerにおける外部CLIは、僕の感覚では「部下モデル」よりも、契約に沿って起動する交換可能な実行器に近い。
親taskが仕事の境界を決め、runnerがその契約を外部processへ運び、workerが担当成果を返す。Codex CLIを選べばCodexが動き、利用者が対応CLIを持っていて選択すればClaudeやGrokも動かせる。しかしproviderが変わっても、親が持つ目標と権限、workerが持つ責務、成果の戻り先という基本形は変えない。
この分離によって、主対話の好みと実行手段の選択を一緒くたにしなくて済む。ただし、外部CLIの認証、料金、利用規約、権限設定までrunnerが一括管理するわけではない。それぞれのproviderに属する条件は、それぞれの側に残る。この境界も、便利さと同じくらい大事だ。
CLI Agent Runnerが実装したのはAI軍団ではなく実行境界
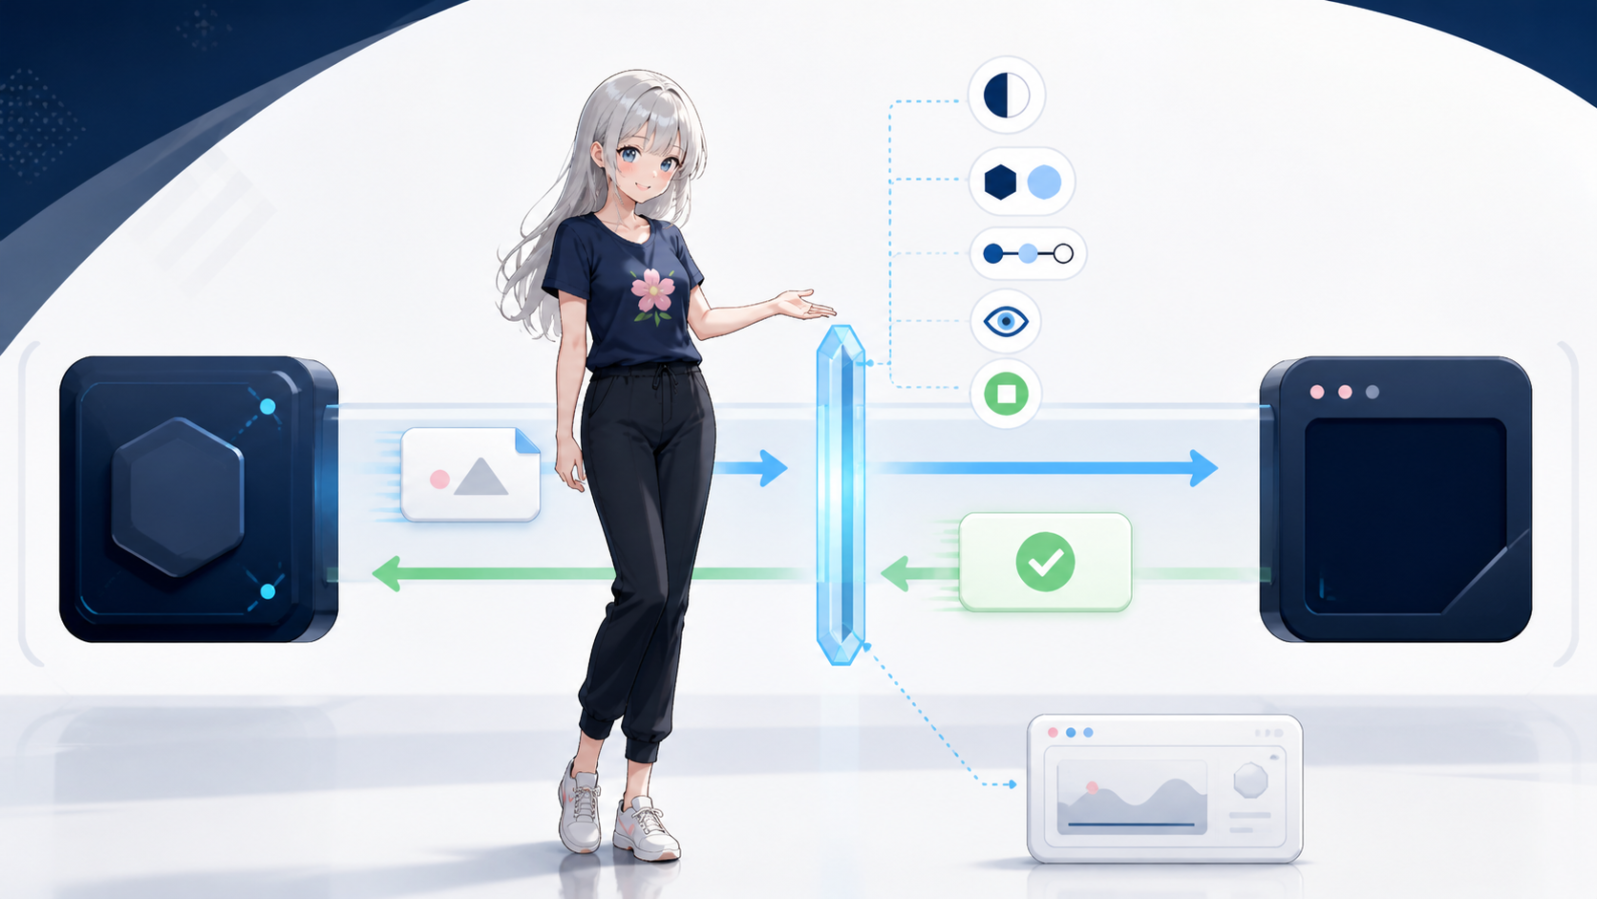
思想だけなら、いくらでも格好よく言える。そこでCLI Agent Runnerでは、「責務を先に定義する」を実際の入力、scope検査、委譲depth、観測、停止条件へ落としている。主役はagentの人数ではなく、ひとつの仕事を安全に受け渡すためのprocess boundaryだ。
role、scope、assignment、expected outputを一組で渡す
worker jobには、誰として働くかを示すrole、どこを所有するかというscope、何をするかというassignment、何を完成させて返すかというexpected outputが必要になる。対象repositoryやtask identityも含め、仕事の輪郭を呼び出し側が決める。
この組み合わせが効くのは、「役割だけ立派で、成果物が曖昧」という事故を減らせるからだ。「あなたは優秀なセキュリティ専門家です」だけでは、何を読んでどこを直し、何を返せば終わりか分からない。反対にファイル名だけ指定しても、なぜ変えるのか、どの品質を所有するのかが抜ける。roleとscopeと完成条件はセットで初めて機能する。
並列化でも同じだ。仕事を小さく切れば速くなるとは限らない。責務が重なる二つのworkerを同時に動かせば、同じファイルや同じ意味を別々に変更し、最後の統合で揉める。CLI Agent Runnerが扱いたいのは、agent数を増やすことではなく、独立して完成できる責務へ分けることだ。
非重複scopeと有限depthで再委譲を囲う
orchestrateでは、各leaf jobのownerScopeが上位scopeの内側にあるかを起動前に確かめ、job同士のscopeが重複していれば拒否する。たとえば一方がsrc/全体、もう一方がsrc/ui/を所有すると、包含関係によって衝突しうる。最初からその二つを並列の独立担当として扱わない。
再委譲も自由なswarmにはしていない。workerがさらに子を呼べるのは、継承したscopeと、正の有限値として残っているdepthの内側だけだ。委譲経路はbrokerを通り、子が親より広い変更権限を勝手に獲得する形にはしない。
ここで有限depthが必要なのは、AIが怖いからというより、責任の所在を追えるようにするためだ。誰が誰へ何を渡し、どのscopeで作業し、結果がどこへ戻るか。無限に増殖する組織図はデモ映えするかもしれないが、失敗時に担当境界を特定できなければ実務ではつらい。
Live Consoleで外部processをブラックボックスにしない
外部CLIを起動すると、「いま何をしているのか」が見えなくなりやすい。CLI Agent RunnerのLive Consoleは、workerの実行過程をloopback上で観測するための表示面で、既定で有効になる。外部へ公開するdashboardではなく、localの実行を追うためのものだ。
大事なのは、Live Consoleが成果物の審査員や自動修理屋ではないことだ。viewerが所有するのはpresentationだけで、workerを起動したり、出力を変更したり、受理したり、失敗を勝手に直したりしない。観測と制御を分けておけば、「見えるようにしたら、いつの間にか別の意思決定者が増えていた」というややこしさを避けられる。
デスクでChatGPT.appを母艦にし、横で外部CLIの動きを眺める。じぴこがスマートフォン片手に様子を見ているくらいの距離感がちょうどいい。司令官が無数のagentへ号令を飛ばす絵より、僕の実際の使い方にはこちらが近い。
成功したら余計なreview chainを足さず止まる
検証が不要なのではない。必要な確認は、案件を作る時点で受理条件に含めておく。成功したあとに「念のため賢いモデルをもう一人呼ぼう」を積み重ねると、誰が成果物の品質を所有したのか分からなくなるし、時間もtokenも際限なく増える。
CLI Agent Runnerが薄いprocess boundaryであろうとするのは、このためだ。成果物を上手に書くのは担当workerの責務、全体へ受理するのは親の責務、runnerはその間の契約と実行を運ぶ。何でも自分で判断する巨大な司令塔にはしない。
類似OSSと比較すると独自性はどこにあるのか
では、似たOSSと並べたときに何が違うのか。ここでは機能の多さや人気を競うのではなく、各projectが何を中心価値にしているかを見る。結論から言うと、同じ「複数のAI coding CLIを扱う」領域でも、agent fleet、multi-model ensemble、session管理、bounded executionでは欲しい道具が違う。
五つのプロジェクトを中心価値で比べる表
比較は2026年8月12日時点の各公開READMEと、CLI Agent Runnerのローカルauthoritative sourceをもとにしている。全製品を同条件で長期運用したhands-on比較でも、速度や回答品質のbenchmarkでもない。GitHub star数、利用者数、市場shareも調べていないため、優劣や人気rankingではなく設計中心の比較として読んでほしい。
| プロジェクト | 中心価値 | 実行単位 | 競合回避または隔離 | 観測面 | CLI Agent Runnerとの違い |
|---|---|---|---|---|---|
| CLI Agent Runner | ChatGPT.appの親taskへスコープ付きCLI workerを一時接続する実行境界 | 責務、scope、assignment、expected outputを持つworker、または非重複leaf job | 実行前のscope包含・重複検査と、実行後のGit変更検査。OS sandboxではない | 既定ONのtoken保護loopback Live Console | 親が目標、権限、統合、最終acceptanceを保持し、成功時に停止する |
| AWS CLI Agent Orchestrator | supervisor-worker型のagent fleetとcross-provider session運営 | tmux上の独立CLI agent session | session分離とprovider native tool restriction | Web UI、CLI、MCP、tmux attach | 永続session、記憶、schedule、direct steeringまで持つ広いcontrol plane |
| MCO | 同じ課題を複数モデルへ投げ、比較、重複除去、consensus、debate、synthesisを行う | providerごとの並列response、またはreview finding | allow-pathsやtarget-pathsによる対象制約 | live terminal streamとJSONL | 責務leafの所有よりmulti-model ensembleと評価合成が主目的 |
| Agent Deck | 多数のAI coding CLI sessionを人間が管理するmission control | 長寿命terminal session | Git worktreeと任意のDocker sandbox | TUIとWeb UI | 一時的なprocess contractよりsession lifecycleと操作性を重視する |
| Claude Squad | 複数terminal agentを手軽に並行利用するTUI | taskごとのtmux session | taskごとのGit worktree | terminal previewとchange review | 簡潔なsession/worktree managerで、責務契約やbroker経由の有限委譲は中心外 |
CAOはagent組織の運営基盤
AWS CLI Agent Orchestrator、略してCAOは、supervisor agentが複数のspecialist agentへ仕事を並列、直列、swarmとして委譲する構成を取る。tmux session、MCP、Web UI、memory、schedule、direct steeringなどを備え、複数providerのagent組織を継続運営するためのcontrol planeとして守備範囲が広い。
多数のagent sessionを立ち上げ、状況を見ながら人間も介入し、組織のように運用したいなら、この広さには意味がある。一方、僕がCLI Agent Runnerで欲しかったのは、ChatGPT.appの親taskから一時的な責務jobを渡し、結果を戻したら止まる薄い境界だ。CAOを小さくしたものというより、中心に置いた問題が違う。
MCOは複数モデルの比較と合成
MCOは、同じpromptを複数のagent CLIへ並列に送り、結果を集約する。その先に比較、重複除去、consensus、debate、synthesisといったmulti-model ensembleの価値がある。同じ設計案を複数人へ配り、多数決や合議から答えを作るイメージに近い。
複数モデルの観点を並べたい、review findingを統合したい、providerごとの回答差を見たいなら、この設計は筋が通っている。対してCLI Agent Runnerは、一つの責務を所有するworkerへ非重複scopeと完成条件を渡す。model votingより「誰がどこを完成させるか」を主題にしているため、同じ並列実行でも意味が異なる。
Agent DeckとClaude Squadはsessionとworktreeの管理
Agent Deckは、多数のAI coding CLI sessionをTUIやWeb UIで管理するmission controlだ。長寿命sessionを扱い、Git worktreeや任意のDocker sandboxを使いながら、人間が複数の作業を行き来する。agentを「今だけ呼ぶworker」より「継続して面倒を見るsession」として扱う用途に向く。
Claude Squadは、tmuxとGit worktreeを使ってtaskごとの作業場所を分離し、複数のterminal agentを手軽に並行利用する。previewやchange reviewを含め、sessionとworkspaceの扱いやすさが中心にある。名前にClaudeとあるが、比較上大事なのはprovider名より、簡潔なTUI session managerという立ち位置だ。
CLI Agent Runnerにも並列実行はあるが、session lifecycle自体を主役にはしていない。worktreeをたくさん開いて人間が巡回する体験が欲しいのか、親taskから責務付きprocessを呼び出したいのかで選ぶ道具は変わる。
CLI Agent Runnerは母艦へ差し込むbounded process boundary
比較して見えてくるCLI Agent Runnerの位置は、ChatGPT.appという母艦へ差し込むbounded process boundaryだ。複数providerを扱えることも、並列に動けることも特徴ではある。しかし独自性の中心は、親の所有権を残し、workerの責務とscopeを機械的に運び、再委譲を有限にし、実行を観測可能にし、成功したら止まるところにある。
機能数で最大を目指してはいない。AI軍団を常駐させたい人には狭すぎるし、複数回答を合議させたい人には淡白すぎるだろう。その代わり、「今いる親taskへ、外部CLIの能力だけを責務付きで接続したい」という用途では、余計なcontrol planeを背負わずに済む。
似たrepoが多いことは、作る意味がない証拠ではなかった。同じ技術要素を使っていても、どこを境界にし、誰へ所有権を残し、いつ止まるかで道具の性格は変わる。僕が探していた独自性は、新奇なagent機能ではなく、この責務配置にあった。
ClaudeやGrokは主役ではない—CLI Agent Runnerが向く場面と限界
CLI Agent RunnerにはCodex CLI、Claude CLI、Grok CLIのbundled profileがある。ただし、三つ全部を契約してAIアベンジャーズを結成する必要はない。標準的にはChatGPT.appとCodex CLIだけで成立し、ClaudeやGrokは選んだ人が、そのCLIを利用できる環境で使うものだ。
Claude未契約でもCodex CLIだけで使える
僕自身がClaude未契約なのだから、Claude必須の設計にしたら自分が最初に困る(笑)。ChatGPT.appを親にし、Codex CLIをworkerとして呼ぶ。まずはそれでいい。別providerを使うために母艦まで交換する必要はないし、使わないproviderの認証や料金を抱える必要もない。
この構成が向くのは、たとえば次のような場面だ。
- ChatGPT.appの会話と最終判断を保ったまま、repository内の実装をCodex CLIへ任せたい
- 複数の独立した変更を、重ならないscopeへ分けて並列実行したい
- workerへroleだけでなく、変更範囲と完成物を明示して渡したい
- 外部CLIの進行をLive Consoleで観測しつつ、成果物の所有者は増やしたくない
- workerからの再委譲を許可しても、scopeとdepthを有限に保ちたい
つまり「何体のAIを飼えるか」より、「ひとつの仕事をどんな境界で渡せるか」が気になる人向けだ。
multi-providerは交換可能性の証明であって看板ではない
custom providerや複数runner profileに対応する意味は、異種モデル軍団を見せびらかすことではない。実行契約を特定providerへ密結合させず、必要に応じて実行器を交換できることにある。
正直、「親GPTでサブがGrok」という編成が世間の大流行になるとは僕はあまり思っていない(笑)。これは市場調査の結論ではなく、僕の率直な見立てだ。それでもGrok CLIを選びたい案件や利用者がいるなら、親の責務設計を崩さず接続できるほうがいい。
重要なのは、provider対応数を価値の中心にしないことだ。三モデルを同時に呼べるとしても、目的、scope、成果物が曖昧なら混乱が三倍になるだけかもしれない。交換可能性はよい設計上の性質だが、案件定義の代わりにはならない。
scope guardはsandboxではない
ここは誤解してほしくない。CLI Agent Runnerのmachine scopeは、OS-levelのwrite sandboxではない。実行前にscopeの包含や重複を検査し、実行後にGitで見える変更が許可範囲に収まっているかをfail-closedで確認する仕組みだ。
したがって、ignored fileへの書き込みやrepository外への書き込みをOSレベルで封じるものではない。悪意あるcommandを完全隔離するsecurity boundaryでもない。必要ならprovider側のpermission、OS sandbox、container、専用worktreeなど、用途に合った隔離を別に用意すべきである。
また、外部CLIの認証、subscription、API利用料、provider固有の権限もrunnerが肩代わりしない。「runnerを入れたから全部安全で全部無料」は、さすがに話がうますぎる。CLI Agent Runnerが守るのは、呼び出し契約と観測、検査の境界であって、計算機全体のsecurity policyではない。
fleetやconsensusが欲しいなら別の道具が向く
もしあなたが欲しいものが、永続的なagent fleet、複数sessionの手動steering、schedule実行、memoryを含む運営基盤なら、CAOのような広いcontrol planeを検討するほうが自然だ。同じ問いを複数モデルへ投げてconsensusやdebateを作りたいならMCOが近い。多数の長寿命CLI sessionとworktreeをTUIで管理したいなら、Agent DeckやClaude Squadの中心価値が合う。
道具の良し悪しではなく、何を所有してほしいかの違いである。CLI Agent Runnerは、ChatGPT.appの親taskが利用者との目標と最終判断を持ち続ける前提で、その外側に限定されたprocess実行を足す。そこが不要なら、無理に選ぶ理由はない。

じぴこ「何でもできるより、どこまでやるか分かるほうが安心ですね」
 管理人
まさにそれだ。境界が狭いことは欠点にもなるが、設計意図どおりの狭さなら価値にもなる。
まとめ:親モデルを選ぶ前に責務を定義する
「親Claude・子Codex」という編成がうまくいくことはある。しかし、それをモデル身分制のように固定し、「GPT親は馬鹿」で片づける前に、僕は案件の形を見たい。目的、正本、権限、scope、成果物、完了条件が揃っているか。親は会話と全体目標と最終受理を持ち、workerは割り当てられた成果を完成させる構造になっているか。そこを曖昧にしたままでは、親モデルの比較以前に仕事が成立していない。
好きな母艦を選び、仕事の境界を先に決める
僕にとって好きな母艦はChatGPT.appだった。旧Codex.appから続く対話体験とシステム設計を残し、外部CLIは必要なときに呼ぶ交換可能な実行器にしたかった。Claudeを契約していないという現実も含め、それが僕の環境に合う設計だった。
あなたの母艦は別の道具でもいい。大事なのは、流行のモデル編成をそのまま借りることではなく、自分がどこで考え、誰が何を所有し、どの実行能力をどんな契約で接続するかを決めることだ。モデルの選択はそのあとでも遅くない。
最初の一歩として、次に親AIへ渡す依頼へ「変更してよい範囲」と「完成物」と「終わってよい条件」を書き足してみてほしい。それだけでも、親の挙動を評価する解像度はかなり変わるはずだ。
CLI Agent Runnerを一文で言い直す
CLI Agent Runnerは、ChatGPT.appの親taskへ、責務、scope、完成条件を持つ外部CLI workerを一時的に接続し、観測可能なまま結果を戻すための実行境界である。
AI軍団の王様を決める道具ではない。好きな母艦を残し、仕事の境界を先に決める。そのうえでCodexでも、必要ならClaudeでもGrokでも、実行器としてきちんと働いてもらう。
管理人僕が作りたかったのは、結局そういう地に足のついたオーケストレーションだったわけだな。
SWELL - シンプルなのに、高機能 – もっと気軽に、楽しく記事を書こう。 それを可能にするWordPressテーマです。
SWELLはGPL100%テーマです。
ライセンス制限はなく、複数サイトでご自由にご利用頂けます。
このBLOGももちろんSWELL使ってますよ!

ロリポップレンタルサーバー
筆者もこのBLOGでお世話になっているレンタルサーバー。 ハイスピードプランはLiteSpeed採用でガチで速いっすよ。
筆者もこのBLOGでお世話になっているレンタルサーバー。
ベーシックプランはガチで速いっすよ。コストパフォーマンス満足度
使い続けたいレンタルサーバー
アフィリエイト、ブログで使いたいレンタルサーバー
サポート対応満足度
すべて1位